
报告结论之前,先问评估者站在哪里
一份安全报告通常把读者的注意力引向最后一页:模型通过了哪些测试,发现了多少问题,是否建议发布。但对于前沿模型,这个顺序可能已经颠倒了。评估者有没有权限访问训练相关信息,能否获得足够的计算资源和时间,是否可以不受实验室干预地发布结果,往往先于测试方法决定报告到底有多大可信度。
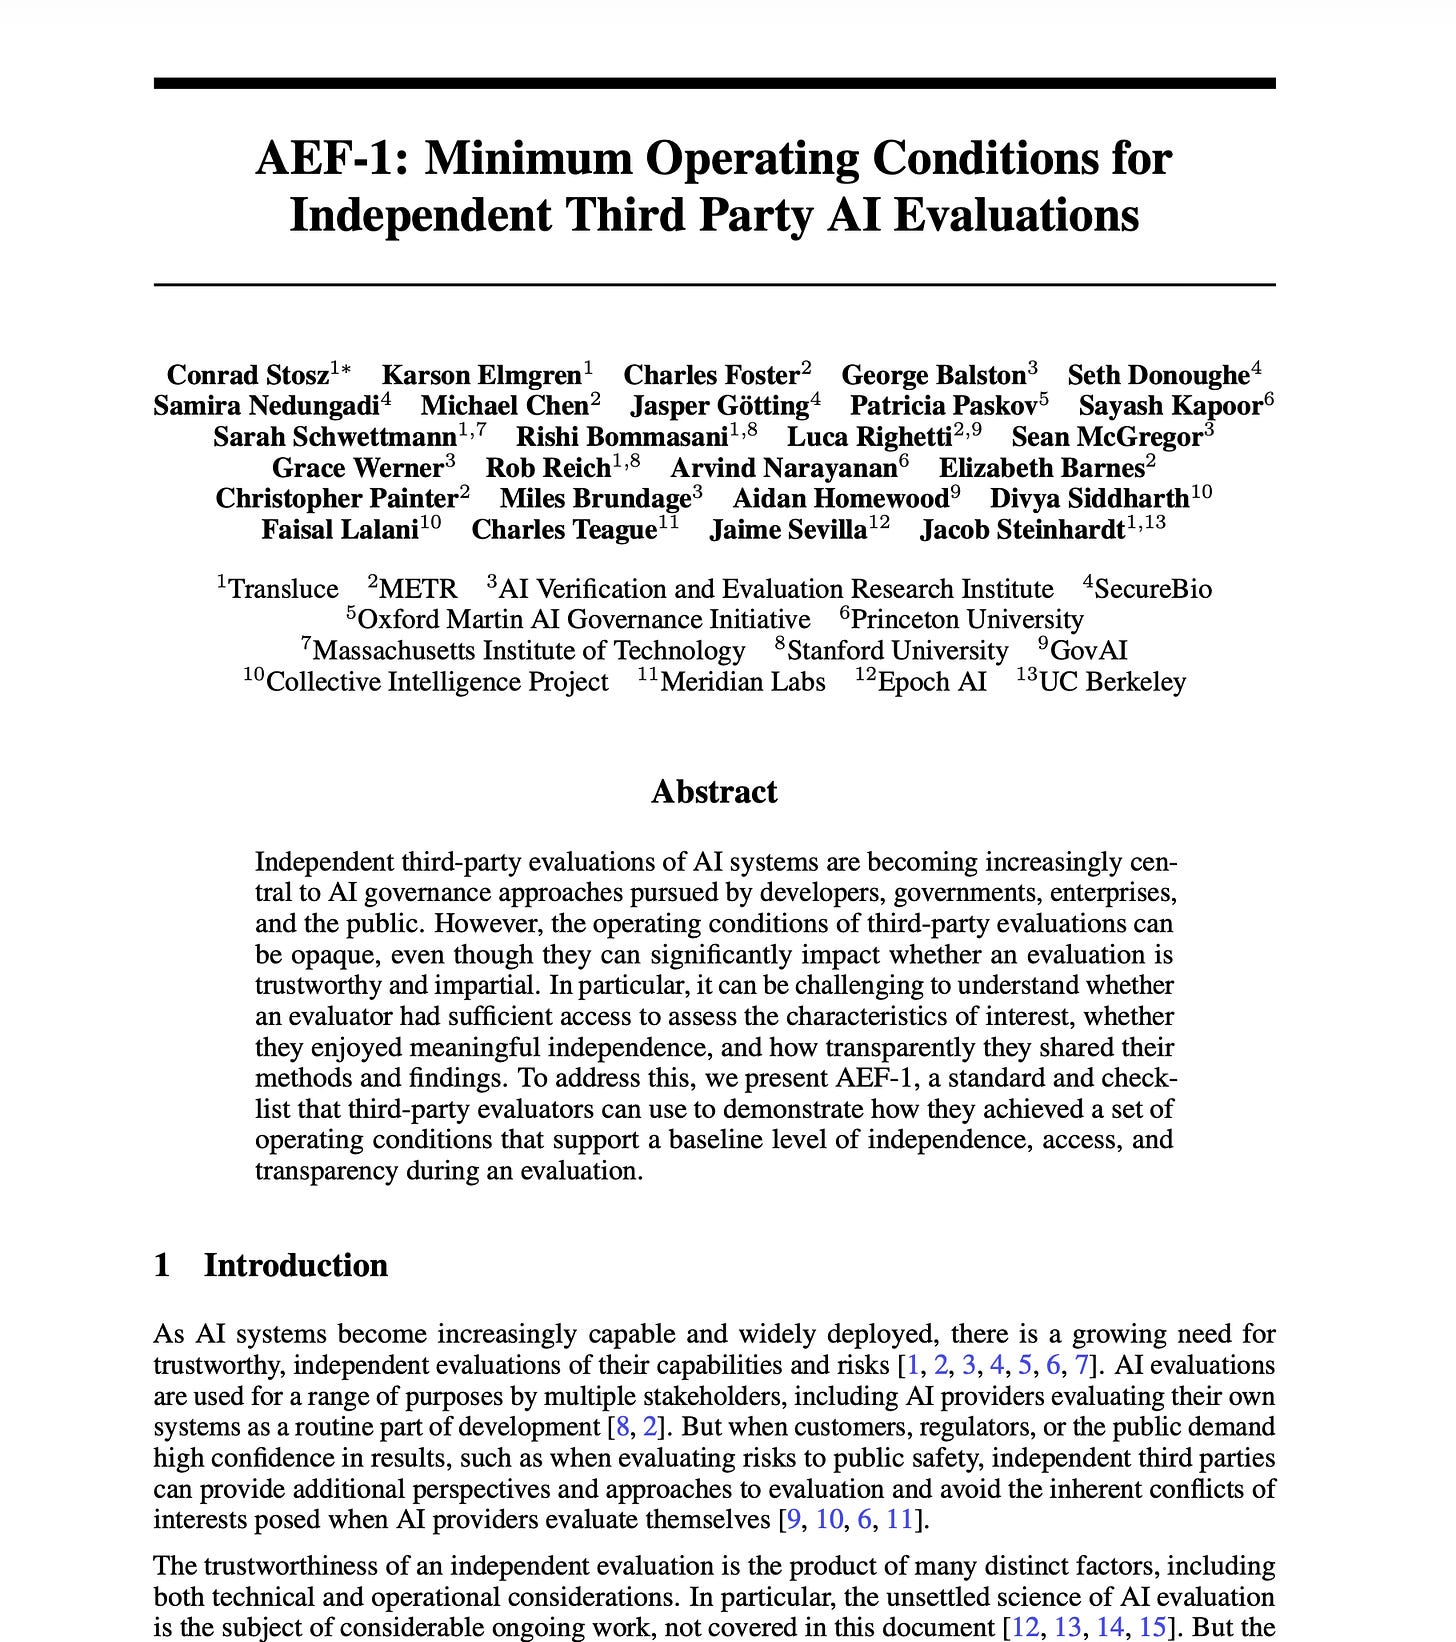
AEF-1的切入点正是这里。AI Evaluator Forum提出的这套标准与检查清单,不直接给模型打“安全”或“不安全”的分数,而是要求评估机构把自身的运行条件和评估结果一起披露。标准覆盖五类问题:访问权限与资源、利益冲突、评估范围与自主性、方法和结果透明度,以及敏感信息保护。若某项条件无法按字面满足,评估者也应说明缺失了什么、为什么缺失。
这使“第三方”不再只是机构名称或报告封面上的身份标签。一个评估团队即使形式上独立,如果只能接触公开接口、无法查看关键资料,或者报告发布需要被评估公司批准,它的结论就必须在这些限制下被阅读。
从发布前测试,转向长期进入实验室
AEF-1所对应的更大变化,是安全评估对象正在从“一个已经完成的模型”扩展到模型背后的生产过程。材料提到的嵌入式评估者设想,是让类似METR的第三方团队持续进入前沿实验室,核查安全实践和组织承诺,报告事故,并观察训练管线与相关流程,而不只是等模型完成后做一次外部测试。
Anthropic被描述为单方面承诺采用这种安排,甚至提供办公室工位、门禁卡和公司电脑,以及大体接近内部风险评估团队的工作空间、工具和权限。这种做法借鉴了银行业监管人员嵌入机构的思路:监督者需要靠近实际业务,才能看到流程如何运行,而不是只接收整理过的材料。
但“更接近内部团队”同时也是风险来源。权限越多,评估者越可能获得有价值的证据,也越可能依赖实验室提供的基础设施、经费和人际关系。嵌入式监督因此不能只写访问清单,还必须配套利益冲突披露、回避机制、直接访问权、编辑控制和不受附加条件限制的发布权。AEF-1的作用,是把这些容易被忽略的组织安排放进报告可见范围。
独立性不是门禁卡能自动带来的东西
这套标准的边界也很清楚:它能证明评估具备哪些前置条件,却不能证明评估结论一定正确。材料没有给出AEF-1的统一评分方法、审计周期、强制执行机制或公众复核流程,也没有说明实验室与评估者发生争议时由谁裁决。拥有内部权限,最多说明评估者更有机会发现问题,并不意味着它一定发现了问题。
这点尤其重要,因为当前安全争论并不只是“有没有做测试”。材料同时记录了另一条分歧:有人担心具备情境意识的模型可能在评估中表现出符合预期的行为,却隐藏真正的失配;另一些观点则把所谓失控事件更多归因于安全控制、网络安全和治理缺陷。无论哪一方更有说服力,AEF-1都无法单独解决测试是否能捕捉隐蔽行为这一认识论问题。
它能做的是让失败更容易被定位。如果报告没有说明模型访问范围、数据限制、删减内容、利益关系和发布障碍,采购方就无法区分“没有发现风险”和“没有条件发现风险”。这是一种不华丽但很关键的改进:把不确定性从报告的脚注,提升为报告的组成部分。
把它写进采购条款,而不是停在联合表态
目前还有一个不能跳过的信息缺口。相关材料称OpenAI、Anthropic和xAI共同同意或支持AEF-1,但另一部分材料主要明确描述了Anthropic对嵌入式评估者的单方面承诺,并没有说明三家公司共同签署的具体形式、持续执行方式或违反标准后的后果。因此,不能把“共同支持”直接写成已经建立了有约束力的行业监督机制。
对企业技术负责人来说,AEF-1最现实的用法不是等待它变成认证标志,而是把条款拆进供应商审查。采购模型或API时,应要求供应商说明评估者看过哪些系统和信息、获得了多少计算与时间资源、是否存在报酬或组织控制关系、哪些内容被删减,以及评估者是否拥有不经供应商批准的发布权。若供应商只能提供安全结论,却不愿披露这些条件,结论的可信度就应相应打折。
同样的要求也适用于评估机构自身。评估方可以用AEF-1说明自己不是“挂名第三方”,但还需要把未满足项和原因公开,明确敏感信息保护与负责任披露的边界。Transluce在2026年8月对77个模型变体进行心理健康评估,并随结果发布运行条件披露和检查清单,展示了这种做法的实际形态;但现有材料没有提供该评估的具体发现,因此不能据此判断模型表现。
AEF-1最终能否产生约束力,取决于实验室、评估机构和采购方是否愿意把这些披露变成持续执行的合同条件。它解决的是“我们凭什么相信这份评估”的一部分,而不是“这份评估一定没有错”。在安全判断中,这个边界必须保留。