
变化不在折扣,而在缓存开始有了运营界面
OpenAI于2026年9月22日发布了GPT-6提示缓存的升级方案,面向的是持续运行数小时、需要连续调用模型完成复杂任务的智能体。此类应用会在多次API请求之间重复携带系统指令、工具定义和前文上下文,OpenAI通过复用这些共享前缀来减少重复计算,并对30分钟窗口内复用的合格前缀提供最高90%的缓存输入token折扣。
单看折扣,这像是一次推理成本优化。但对长时智能体而言,缓存命中率同时决定首字节延迟、单位任务成本和系统能否稳定扩展。GPT-6新增的缓存面板、miss诊断、显式断点和预热机制,说明缓存已经不再只是模型服务内部的隐形加速,而成为应用团队需要持续观测和治理的一层运行基础设施。
智能体的缓存单位,其实是不断变化的上下文
这套机制复用的不是某个孤立提示词,而是连续请求中保持稳定的前缀。指令、工具定义、schema、工具排序以及此前积累的参考材料,只要这些内容保持一致,后续请求就有机会复用已经完成的处理。相反,工具定义发生变化,哪怕变化只影响上下文的一部分,也可能让整个可复用前缀失效。
OpenAI给出的诊断示例把这一点变成了可定位的问题:一次请求因为tools_changed未命中,比较结果显示有5629个可复用token同时成为未命中token。这个数字的价值不在于它有多大,而在于它把“缓存怎么突然失效”从猜测变成了具体的变更事件,开发者可以进一步判断是模型、工具、设置还是输入造成了复用中断。
新工具把缓存优化接入了SRE工作流
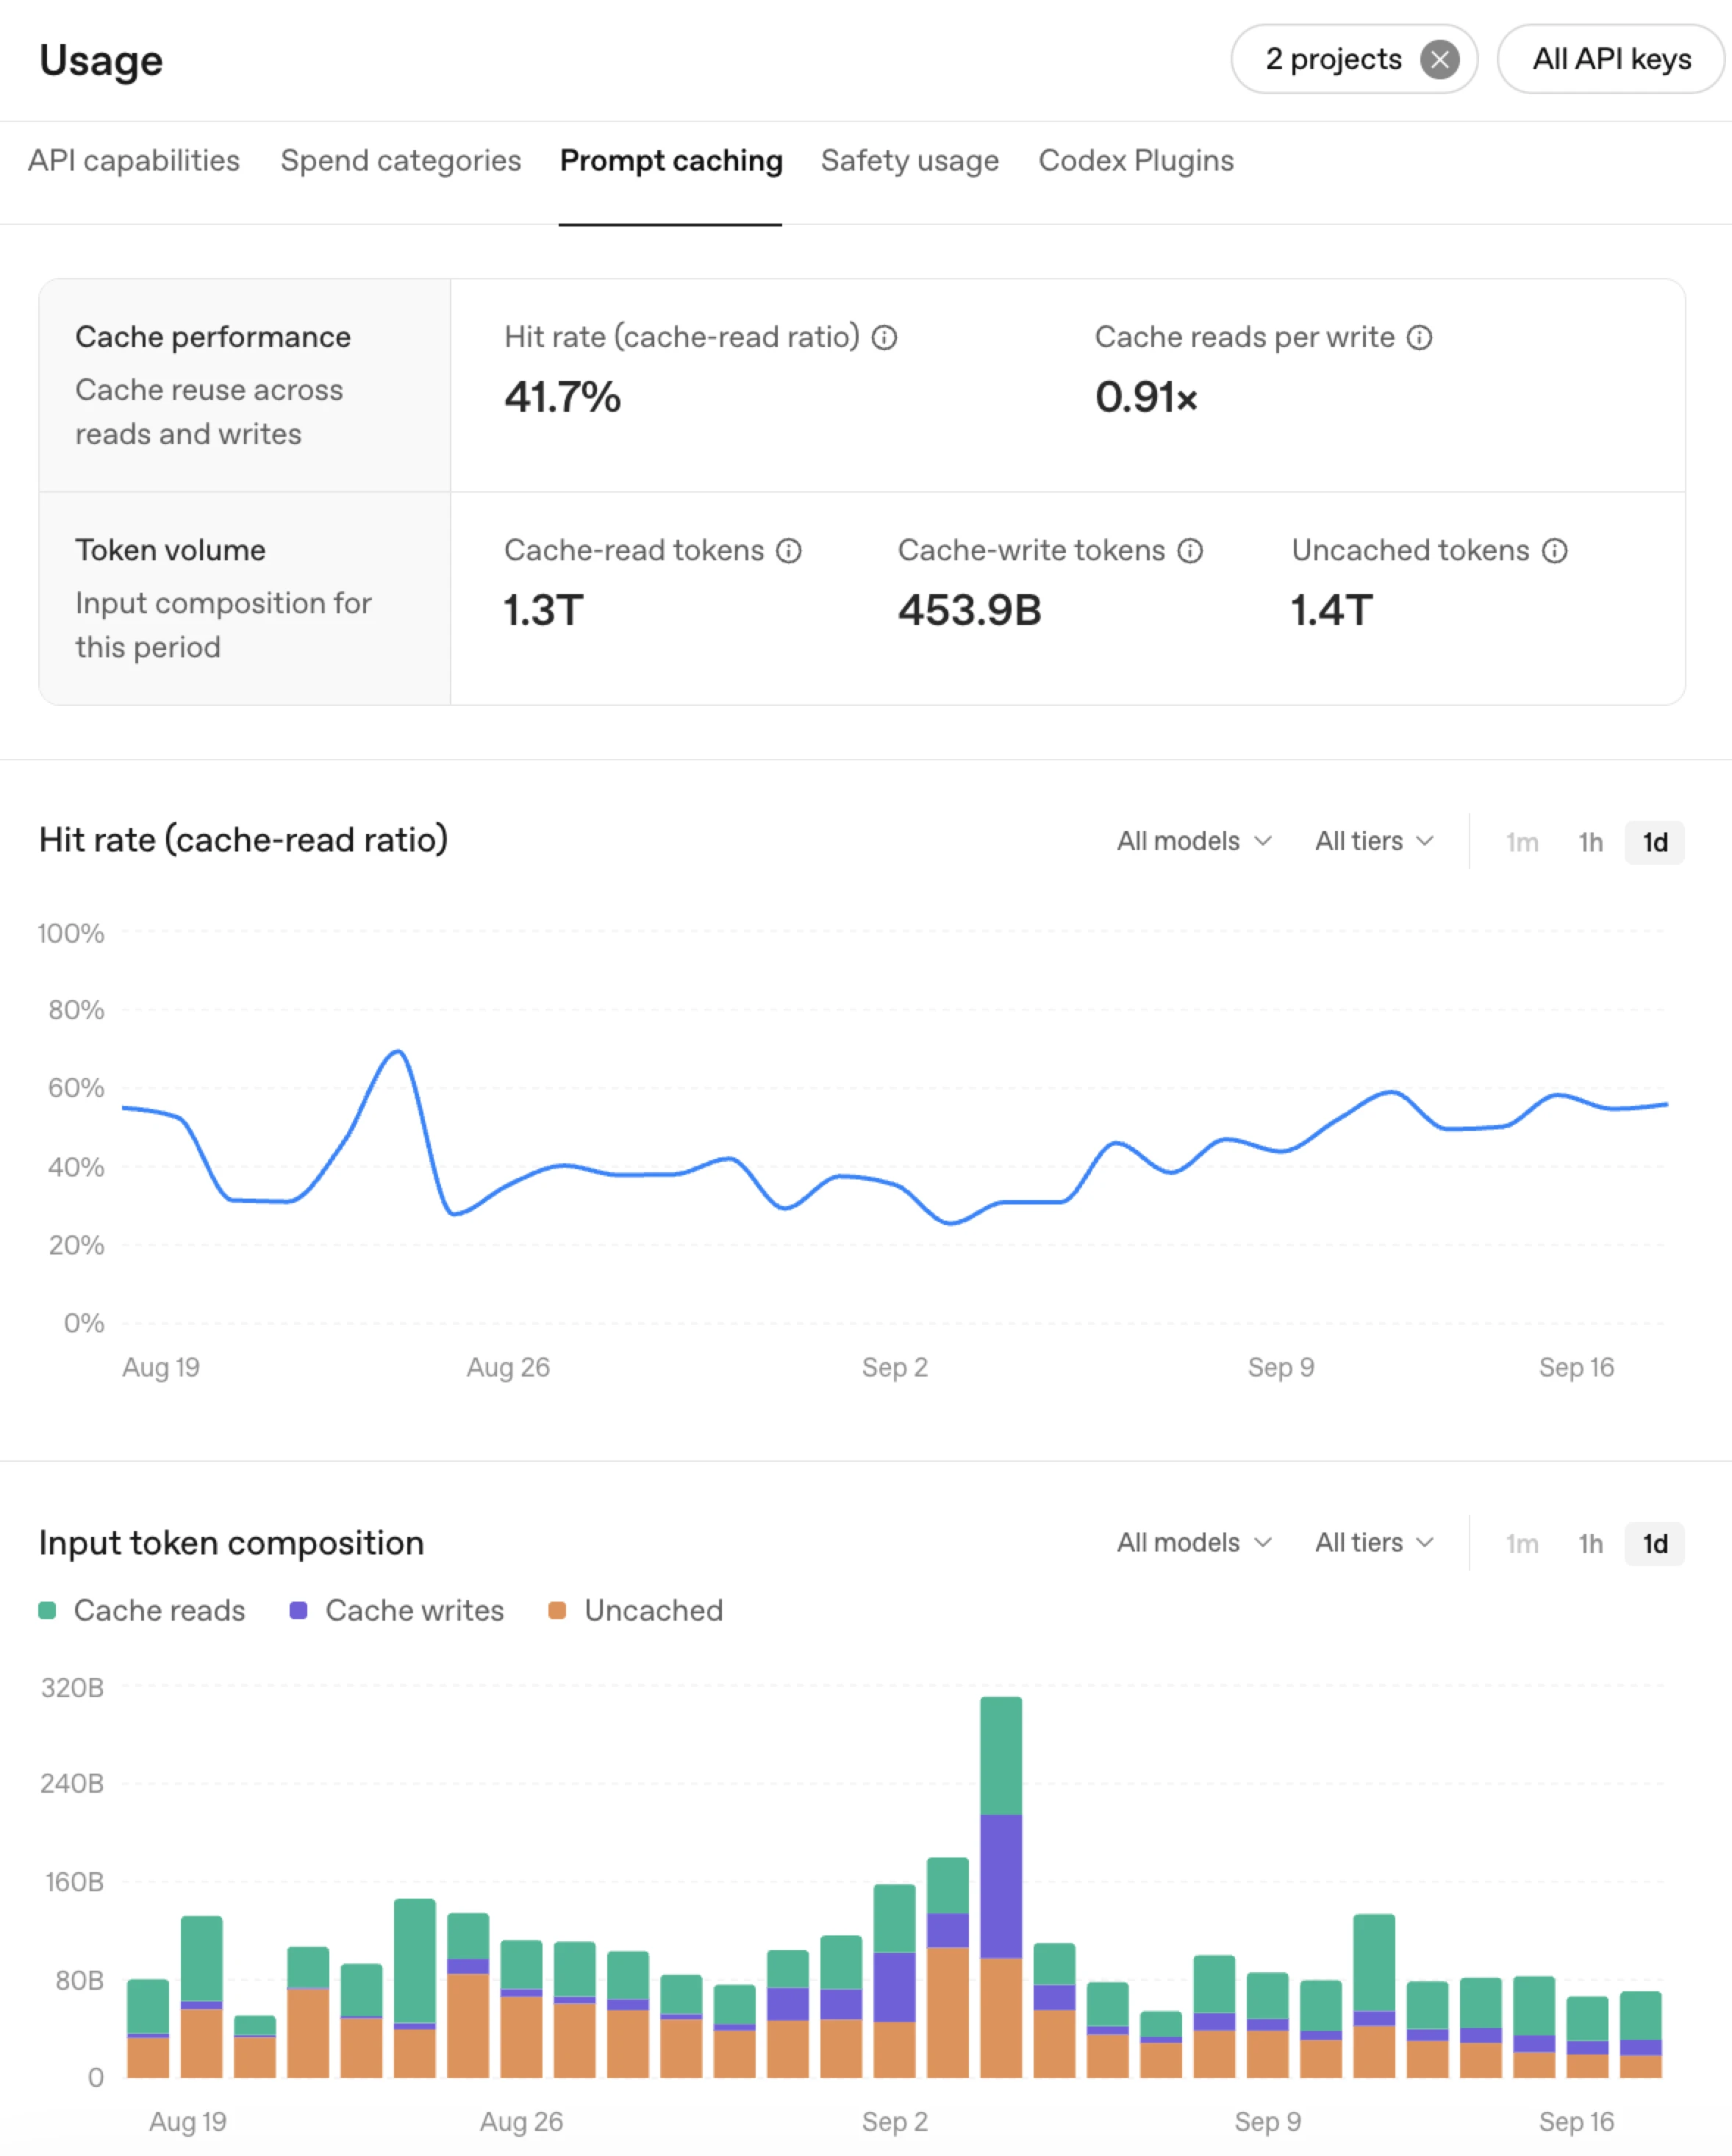
Prompt Caching Dashboard用于观察一段时间内的命中率,以及输入中缓存token和未缓存token的构成。它让团队能够把应用改动与缓存表现放在一起比较,识别某次工具升级、上下文重组或请求策略调整是否造成了命中率下降。诊断工具则进一步解释单次miss,并估算受到影响的token规模,这使缓存可以像延迟、错误率一样被纳入日常排障。
开发者还可以用显式cache breakpoint选择哪些前缀值得复用,用预热在用户发起请求前准备共享指令、工具定义或参考材料。GPT-6允许在连续响应之间调整reasoning effort,而不破坏已有缓存,这意味着系统可以针对困难任务提高推理强度,对例行跟进降低推理强度,同时保留前面已经处理过的上下文。缓存因此不再只是“尽量命中”的经验,而开始具备边界设计、容量判断和运行时调节。
代价是工具灵活性要让位于上下文稳定性
为了保住缓存,应用需要稳定工具定义、schema和工具顺序。OpenAI建议不要在不需要某个工具时直接删除它的定义,而是用allowed_tools限制当前可调用范围,或者在不需要工具时将tool_choice设为none。新增开发者消息也可以追加在上下文末尾,用较新的指令覆盖旧指令,而不是反复重写前面的共享前缀。
这套做法把工具版本治理推到了智能体架构的核心位置。它能减少缓存失效,却也意味着接口变更不能只看功能是否正确,还要评估会不会破坏大段上下文的复用。显式断点、预热和诊断同样需要工程维护,90%的缓存输入折扣也不等于端到端成本下降,因为工具调用、未命中请求、上下文维护和额外治理仍然会产生代价。
真正该看的指标,是每个任务而不是每次请求
材料中的部署反馈显示,这种优化可以产生可观的实际变化。GitHub Copilot表示,在数十亿次请求中,需要新鲜处理的prompt token占比相较此前基线下降了50%以上。Manus的生产环境案例则显示,团队通过调整缓存断点、结合显式与自动缓存,并用真实请求定位异常miss,命中率在不到一周内从约85%提升到稳定的90%以上。
这些数字不能直接被当作所有应用都能复制的结果,因为工作负载、上下文长度和工具变更频率并不相同。但它们给出了一个更实用的判断方向:长时智能体应该把缓存命中率、未命中token、首响应延迟和单位任务成本放在同一张运营账上。对技术负责人来说,优先级不是盲目追求最高命中率,而是找到一个不会过度牺牲工具演进速度、又能让任务经济性稳定的上下文结构。