
一款模型同时回答“未来会怎样”和“现在该怎么动”
Black Forest Labs发布的FLUX 3 Action,是一个面向机器人控制的7B开放权重World Action Model。它接收相机画面、机器人状态和文字指令,把这些信息编码成token,再由FLUX 3多模态骨干同时预测未来视频帧和下一段机器人动作。对机器人系统来说,这解决的是一个长期存在的分叉:模型究竟应该重点理解环境的变化,还是直接输出下一步控制信号。
传统的世界动作模型更擅长预测未来画面,因此能把动作放进更长的因果链里,但视频生成会带来很高的计算成本。视觉语言动作模型则更直接地输出动作,推理通常更快,却可能牺牲对未来状态的显式建模。FLUX 3 Action没有在两条路线之间二选一,而是让视频token和动作token共享同一个骨干,再通过两个解码器分别还原画面和关节指令。这个设计解释了它为什么值得技术负责人阅读,但也意味着部署时不能只看一个动作头的延迟。
榜首成绩背后,最重要的变量不是7B参数
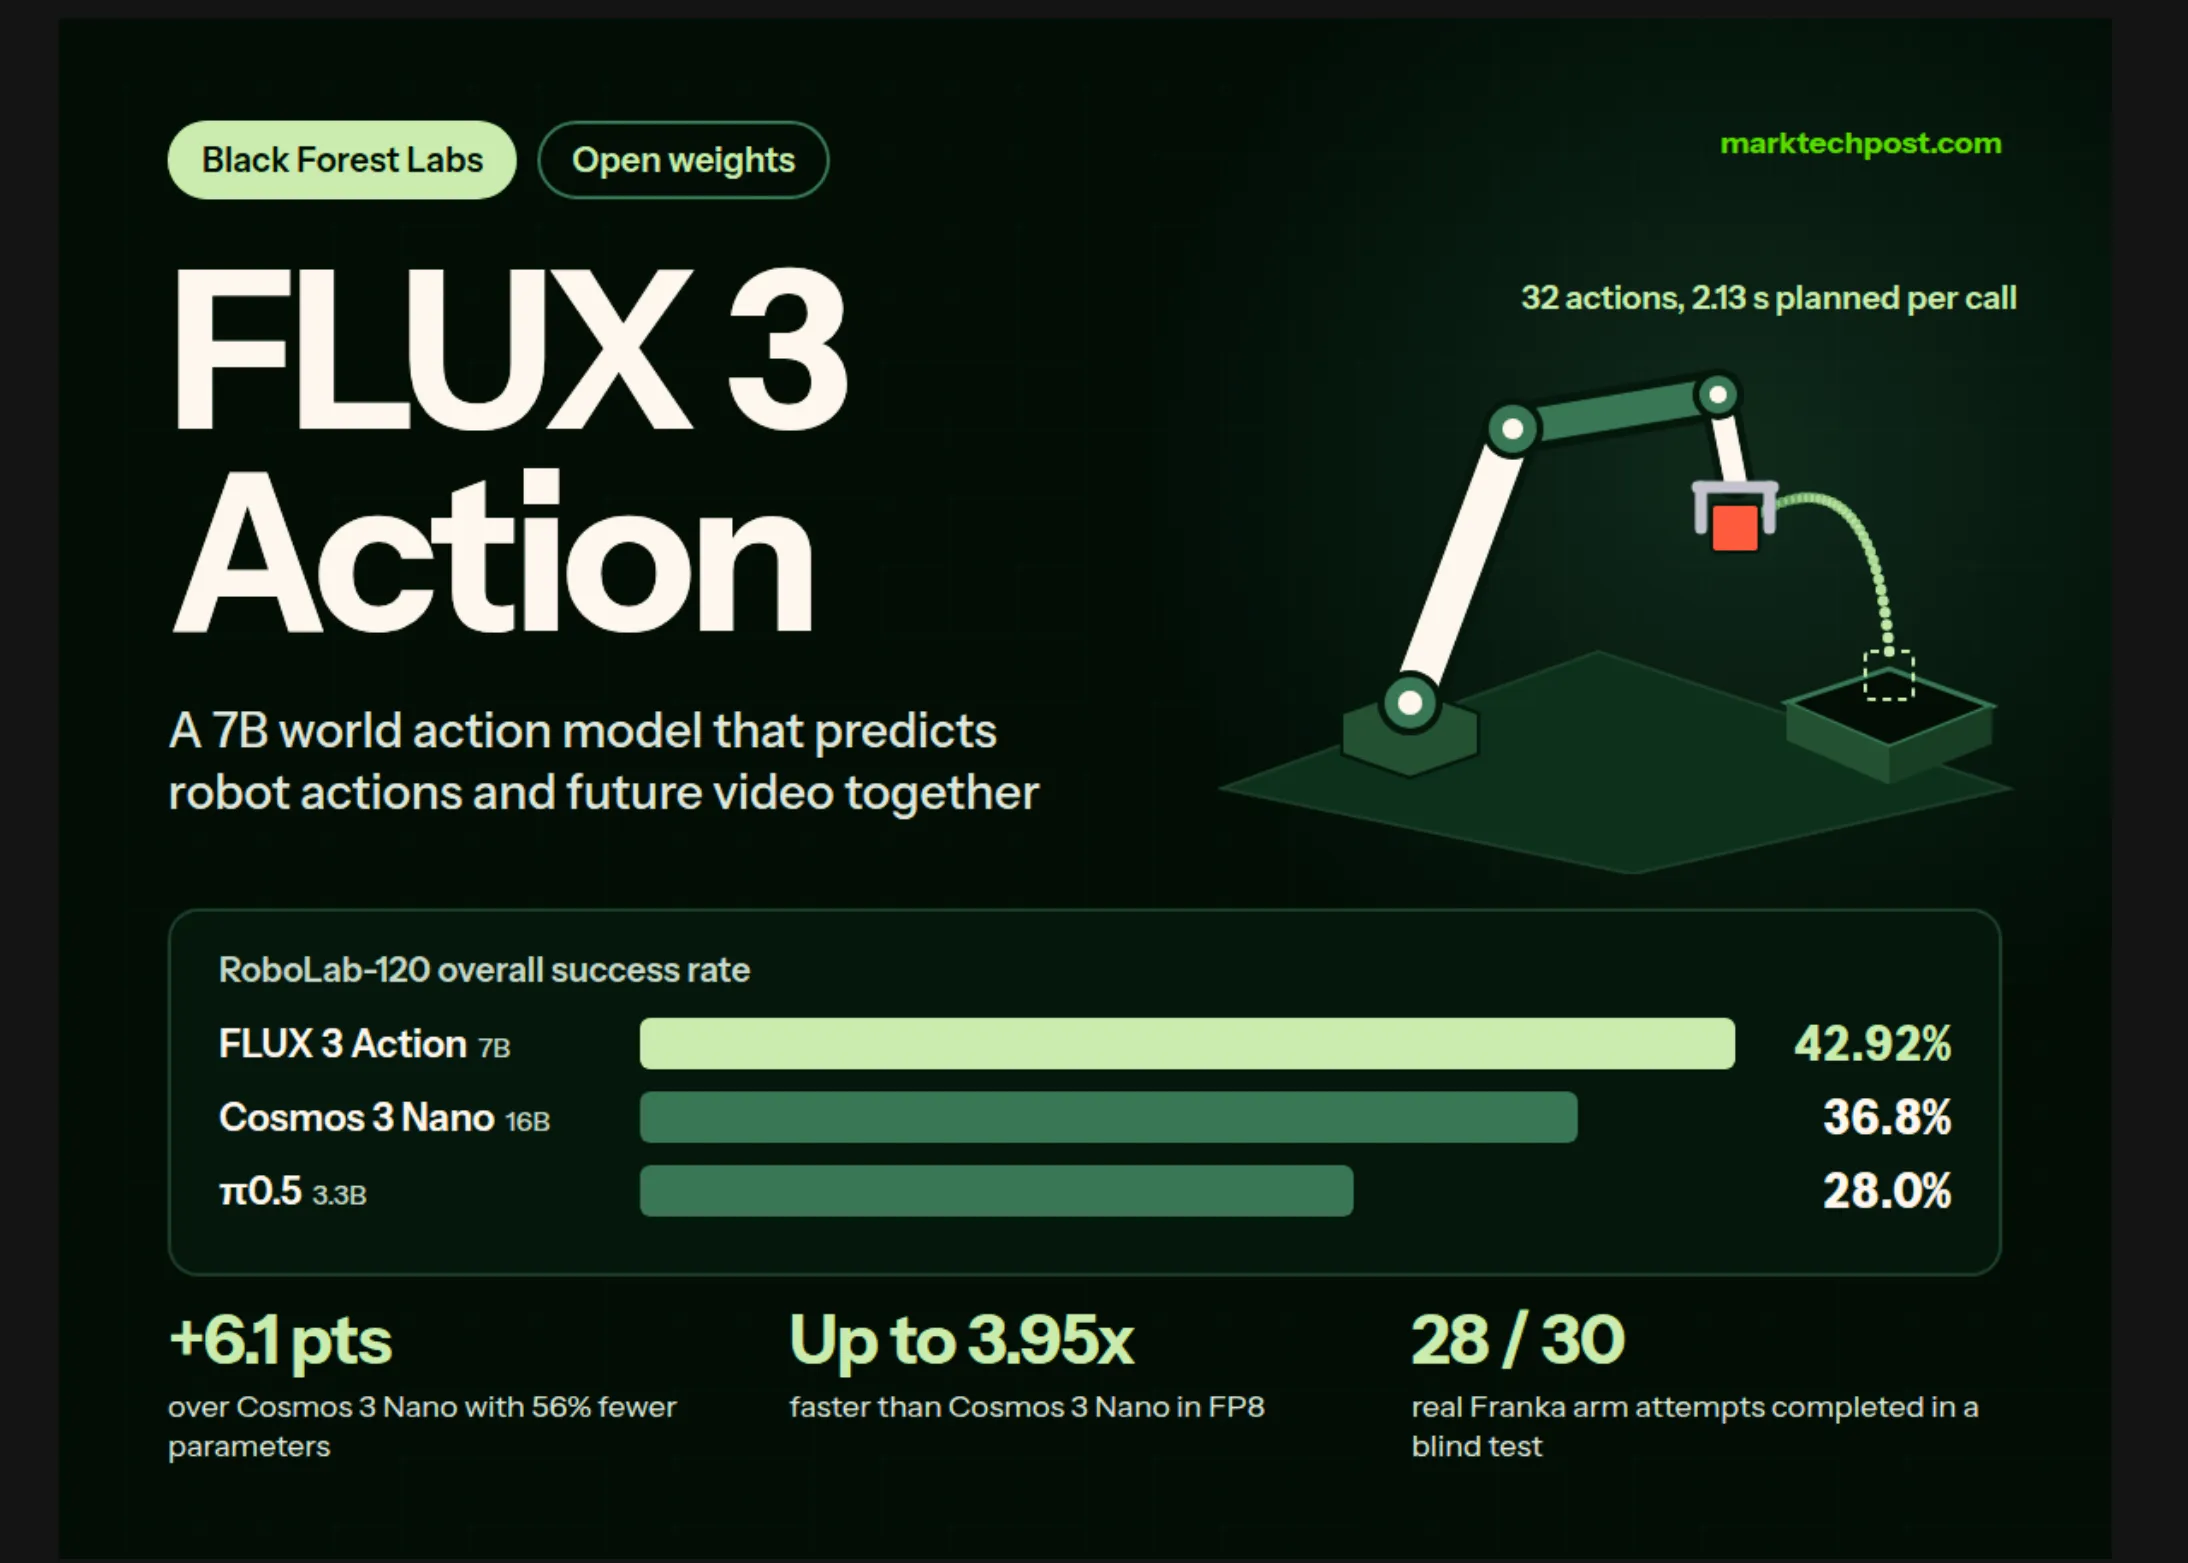
FLUX 3 Action在RoboLab-120上的成功率为42.92%,排名第一。对比模型中,16B的Cosmos 3 Nano为36.8%,3.3B的π0.5为28.0%,14B的DreamZero为25.7%,3B的GR00T N1.6为7.2%。这意味着FLUX 3 Action以少56%的参数领先Cosmos 3 Nano 6.1个百分点,但这个结果不能简单归结为“更小的模型更强”。
更关键的证据来自训练消融。只用DROID数据训练时,成功率低于1%。在相同协议中加入预训练后,结果提升到11.6%。FLUX 3 Action的预训练数据包含图像、视频和音频,其中视频占训练token的95%以上。随后,中训练阶段将36.95%的预训练样本与63.05%的动作对齐视频混合,动作数据覆盖游戏录制、第一视角人类手部视频、手持夹具和14种机器人形态。换句话说,7B规模只是最后的容量表达,真正让模型具备迁移能力的,是先从大量视频中学习世界如何变化,再把这种表示接到动作空间上。
蒸馏把世界模型的成本压低,也把选择权交给部署方
BFL为DROID策略提供了三种速度与质量配方。基础版本使用4步采样,并采用视频CFG 4、动作CFG 1的分离引导。引导蒸馏版本取消第二次引导计算,速度提升约1.8至2倍,成功率反而高出0.6至1.08个百分点。单步蒸馏版本则把采样压到1步,速度提升3.15至4倍,但成功率下降3.51至4.32个百分点。
这不是一个“默认越快越好”的部署故事,而是典型的质量预算问题。每次调用返回32个、频率为15Hz的动作,相当于规划2.13秒的运动。π0.5每次调用只返回1秒,因此BFL用实时因子,也就是计算时间与所生成运动时长的比值来比较速度,而不是只报告单次调用延迟。与Cosmos 3 Nano的FP8版本相比,基础版和引导蒸馏版在消费级、工作站和数据中心GPU上快1.52至3.95倍。但单步蒸馏在工作站和数据中心GPU上虽然比π0.5快1.34至2.28倍,在RTX 5090上却仍然更慢。硬件和精度设置会改变结论。
**证据块|部署门槛**:DROID策略以BF16运行在H200上约需32GB GPU显存。采用FP8量化并卸载文本编码器后,可以适配24GB显卡。这个结果说明开放权重不等于低成本运行,也说明模型压缩的收益需要和目标GPU一起评估,而不能只看参数量。
仿真领先之外,实机信号很好,但证据仍然很窄
RoboLab-120包含Isaac Sim中的120项桌面任务,每项任务在DROID风格的Franka设置下进行10次试验。这个基准足以说明模型在统一任务集上的相对位置,却不足以证明它已经具备跨环境、跨硬件的通用控制能力。特别是,视频世界建模在仿真中的收益,未必能完整转移到光照、摩擦、遮挡和执行误差都更复杂的真实场景。
实机结果提供了一个积极但有限的补充。Positronic Robotics在Franka机械臂上对10项DROID任务进行盲测,每项尝试3次。FLUX 3 Action完成了30次中的28次,成功率93.3%,Cosmos 3 Nano为27次,DreamZero为20次,π0.5为13次。这个28比27的差距说明它至少没有把仿真优势完全丢在真实硬件上,但30次尝试仍不是规模化部署的统计保证。技术负责人应把它视为“值得继续做现场验证”的信号,而不是验收结论。
开放权重并不等于可以直接接管机械臂
FLUX 3 Action的开放性主要体现在权重和部署配方,而不是完整的商业使用自由。FLUX Kommunity License允许非商业使用,因此研究、原型和内部验证可以从中受益,但商业产品需要先解决许可边界。对准备把模型接入机器人产品的团队来说,许可证不是发布说明里的附注,而是系统架构和采购决策的一部分。
安全边界同样不能由模型自动补齐。给定材料显示,模型输出的是未来动作块,模型本身没有内置速度、力或工作空间限制。工程系统仍需要在动作执行层加入约束、急停、碰撞检测和失败恢复逻辑,并决定每次动作块执行多少、何时重新规划。更现实的路线,是先在现有遥操作或示范数据上验证策略,再分别比较基础版、引导蒸馏版和单步蒸馏版在目标硬件上的成功率与实时因子。若任务对失败代价敏感,不能为了追求单次推理速度而默认选择单步版本。
FLUX 3 Action给出的可执行判断很明确:它适合被当作一种把视频世界建模压缩进机器人策略的候选底座,尤其适合研究长时程预测与动作输出如何共享表示。但在商业化或高风险控制中,团队必须同时复核三件事:目标GPU是否真正承受得住,评测任务是否覆盖真实分布,许可证和安全约束是否已经进入系统设计。只有这三项都成立,42.92%的榜首才有机会转化为现场能力。