
把机制串起来
生成式模型是“写出答案”,而CLM是“在给定候选动作中打分”:它把当前状态和每个候选动作编码成向量,再计算匹配程度。对分数做softmax后得到的是候选集合内的相对概率,不是脱离候选集的绝对可信度。状态可以是用户请求、环境观测或Agent上下文,动作可以是工具、回答、代码方案或下一步操作。
CLM使用冻结的Qwen3-8B作为共同语义底座,再接约2000万参数的状态投影头和动作投影头;两者分别把状态与候选动作映射到可比较的向量空间。双向InfoNCE让真实采取的动作靠近当前状态,同时把其他动作推远,因此训练目标直接对应“在候选中选对动作”。推理时只需计算状态向量与各动作向量的点积,再对候选分数做softmax;同一原语即可支持分类、等级评分、工具路由和best-of-N筛选。状态与动作被解耦后,固定动作集的向量可以缓存,反复变化的状态只需重新编码;约1000候选
['候选动作固定或可枚举时最适合CLM', '用作代码Agent验证器,先生成多方案再排序', '必须保留候选集合,概率不可跨集合直接比较', '不适合需要自主生成候选文本的场景']
它发布的不是另一个聊天模型
Contrastive-LM发布的CLM-8B,是其所谓Contrastive Language Model新类别中的第一个开放模型。它面向的不是“根据上下文写出下一段文字”,而是让系统针对当前状态,从一组候选动作中判断哪一个更合适,并返回概率、选项或有序分数。其主要对照对象是TypeSafe AI的专有System One模型Jev,后者同样提供带概率的类型化结果,而不是普通文本回复。
这一区别会直接改变智能体的架构边界。传统智能体往往让生成模型既提出动作,又通过额外提示来判断动作,结果是每一步都要重新处理一段文本。CLM-8B把“提出候选”和“给候选排序”拆开,让生成器负责扩大搜索空间,让评分器负责在已有选项中做选择。对于工具调用、最佳候选筛选和代码代理验证,这不是换一个模型名称,而是把决策环节从生成任务中剥离出来。
速度来自状态与动作的拆分
CLM-8B的核心不是让Qwen3-8B生成得更快,而是让它不再生成。模型使用一个冻结的Qwen3-8B作为骨干,并为状态和动作分别接入约2000万参数的投影头。训练时,双向InfoNCE目标会把实际采取的动作拉近当前状态,把其他动作推远。推理时,系统只需计算状态向量与各动作向量的点积,再通过softmax得到分布。
这种设计尤其适合状态持续变化、动作集合相对稳定的智能体循环。clm-serve会在GPU上保留类似vLLM KV cache的专用缓存,复用已经编码过的状态和动作向量。材料给出的例子是,在一张RTX 4090上、候选动作数为3时,重复访问的状态从1.7毫秒降到0.6毫秒。约1000个候选动作的模型卡测试则报告了相对Jev最高13倍的速度,这说明加速不仅来自模型参数量,也来自向量复用和避免逐候选生成。
训练曲线说明,负例不是越早越多越好
CLM-8B采用了三阶段训练路径。第一阶段使用约6000万条Nemotron DQA问答数据进行预训练,第二阶段加入约3000万条由Gemini 2.5 Flash-Lite生成的合成困难负例,第三阶段再用约100万条来自Agent Data Protocol、Endless-Terminals和LiteCoder-Terminal-SFT的智能体轨迹做后训练。这套顺序的含义是,模型先建立基本的状态—动作对应关系,再学习区分相似但错误的选择,最后适应真实代理流程。
材料中的对照结果支持这种安排。约10万条留出问题上,只有预训练时top-1准确率为52.1%,加入中训练后升至69.2%。如果从一开始就使用困难负例,最高只有62.4%,随后出现过拟合。对技术负责人而言,这比某个最终准确率更有用,因为它揭示了评分模型的瓶颈:如果基础表示还没有形成,继续增加“很像正确答案的错误答案”可能只会让模型过早记住局部边界,而不是获得更稳的判断能力。
九倍并不等于全面胜出
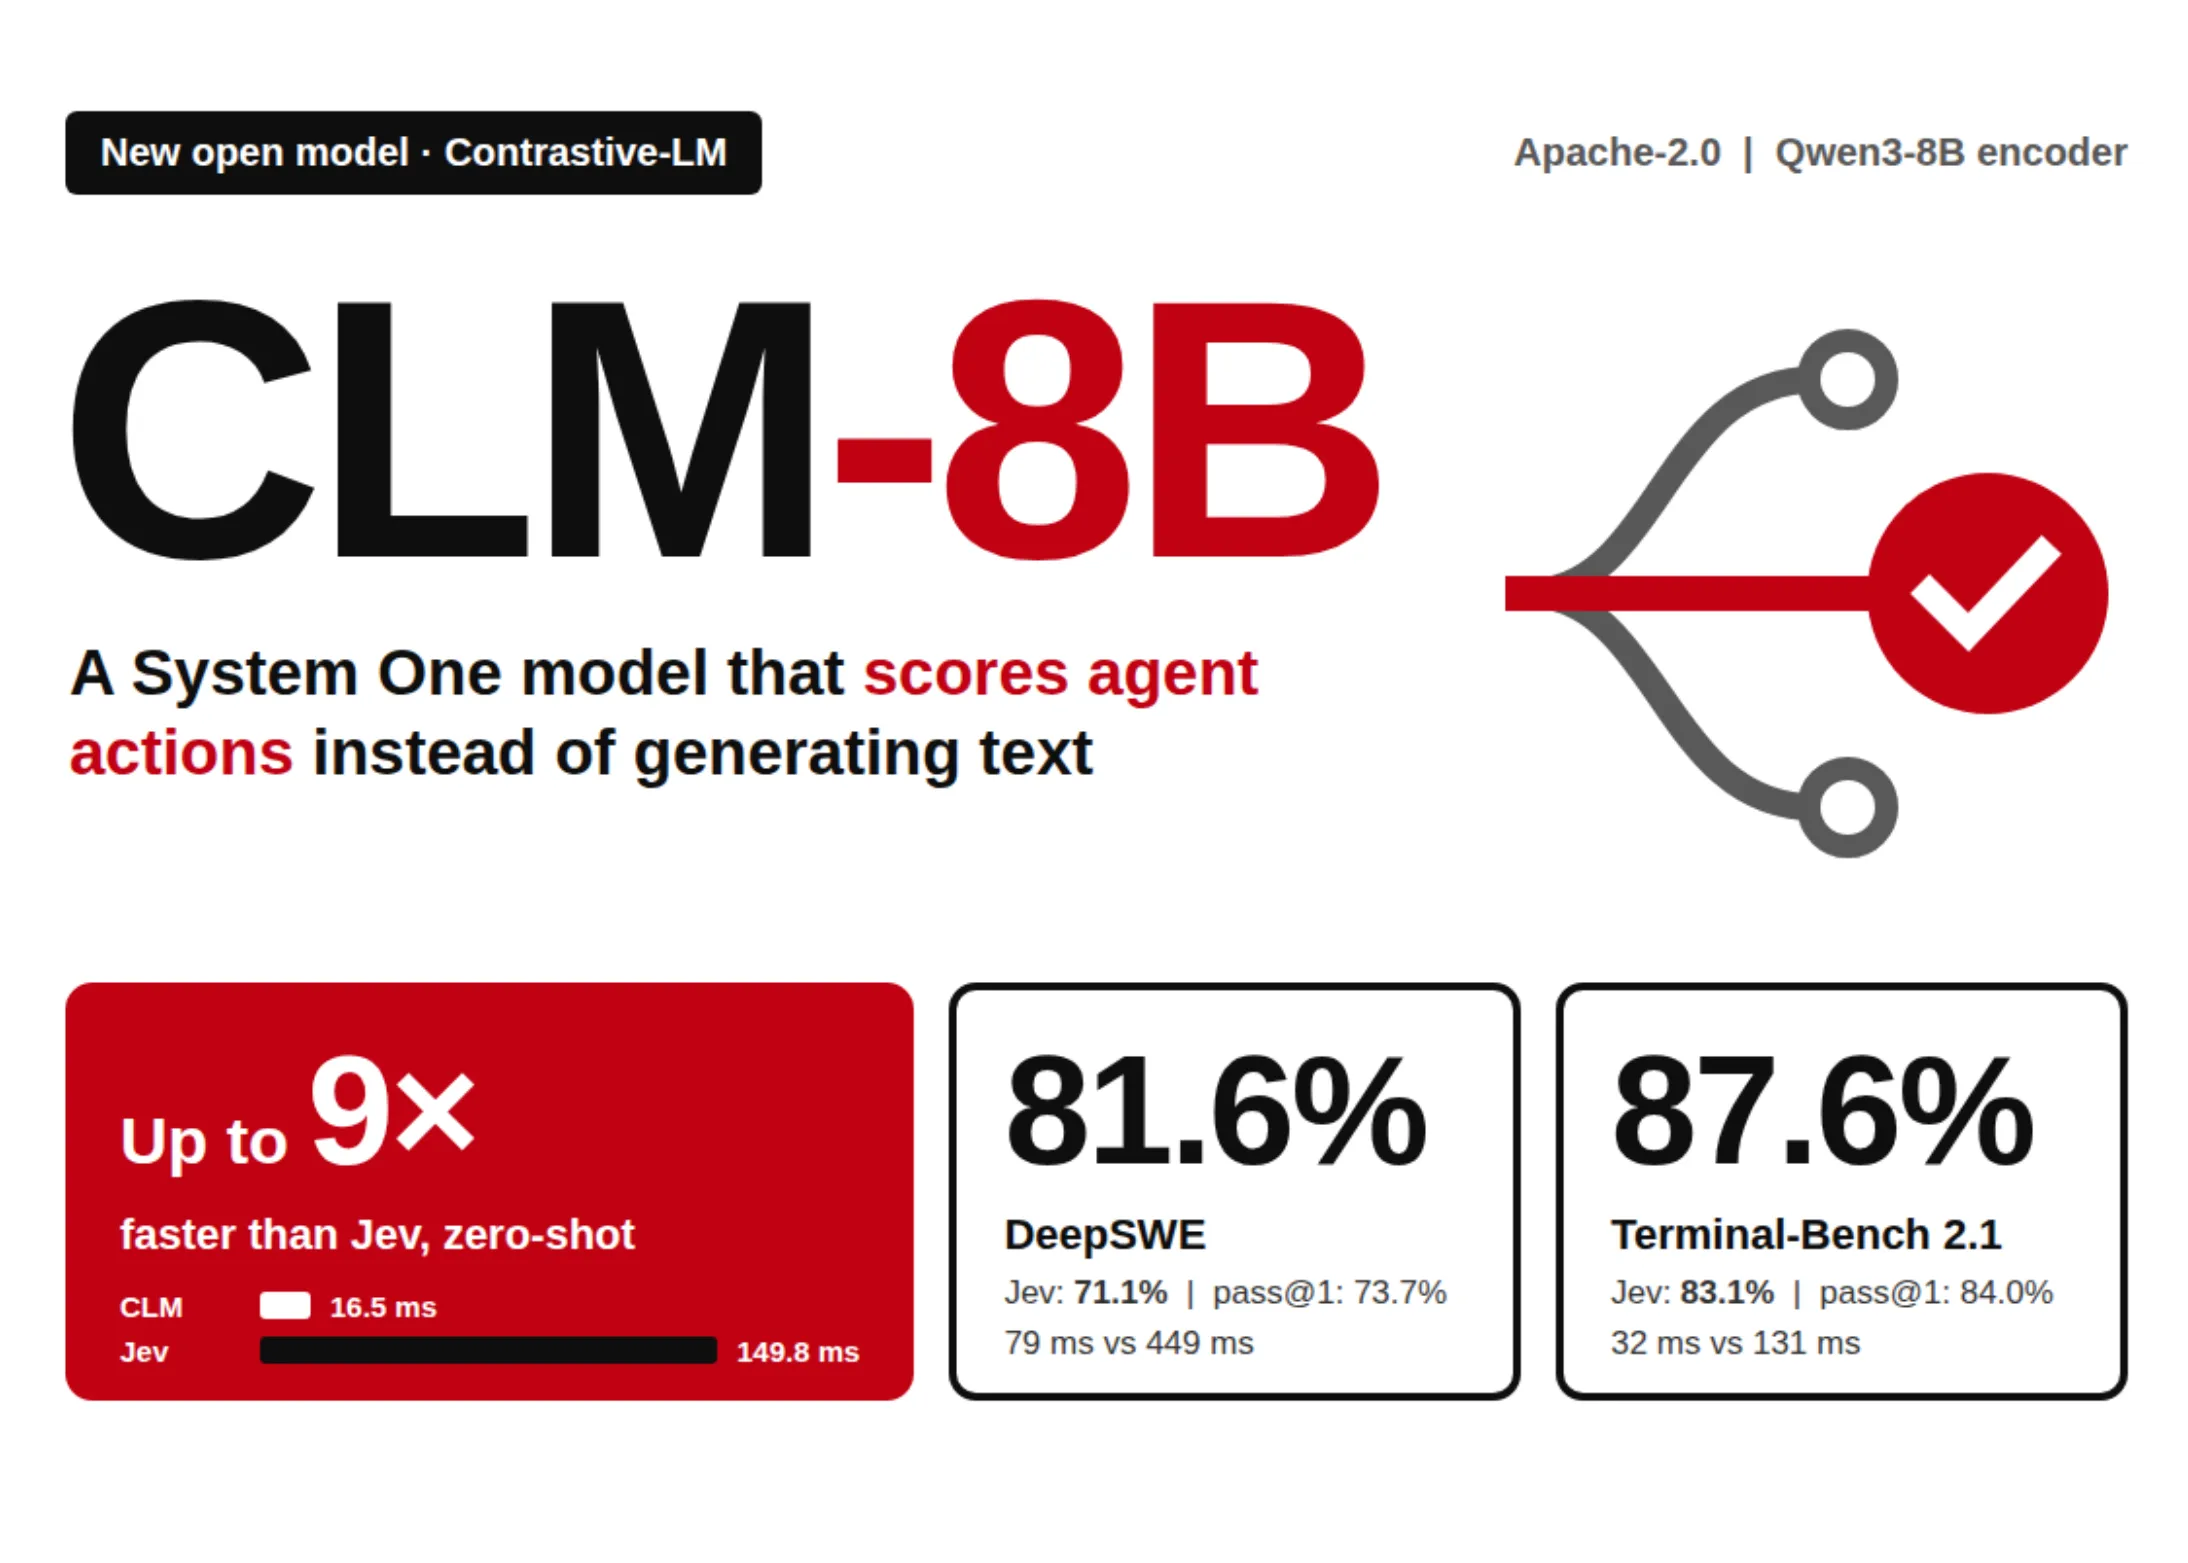
CLM-8B在零样本测试中的优势集中在特定结构上。T-Rex游戏中,它用16.5毫秒完成一次判断,Jev为149.8毫秒,双方都是5次成功。Super Mario中,CLM-8B为33.5毫秒,Jev为132.6毫秒,同样都是5次成功。材料明确指出,T-Rex的“9倍”来自动作在不同状态间反复出现,因此动作向量缓存能够持续发挥作用。
但在工具调用和WikiRacing上,速度优势并没有转化为相同的质量。BFCL v4工具调用测试中,CLM-8B为76.8毫秒、准确率95.2%,Jev为125.5毫秒、99.2%。WikiRacing中,CLM-8B为79.8毫秒并完成26/30,Jev为225毫秒并完成30/30。这个结果给部署决策划出了一条清楚的线:如果错误动作成本高,单纯用低延迟交换准确率未必划算,除非系统还保留重试、拒绝或更强模型复核机制。
更现实的用法是给生成器做验证
CLM-8B最有说服力的应用路径,是作为代码代理的候选验证器,而不是独立承担所有决策。测试中,Opus 5为DeepSWE生成best-of-4候选,Fable 5为Terminal-Bench 2.1生成best-of-5候选,再由经过微调的CLM头选择结果。在38个留出的DeepSWE任务上,验证后的结果从73.7%提升到81.6%,在30个留出的Terminal-Bench 2.1任务上,则从84.0%提升到87.6%。
这组结果同时必须带着限定条件阅读。使用的是轻量微调后的头,不是零样本检查点,评估也只是留出子集而非完整排行榜提交。Jev在这两个基准上的表现低于pass@1,说明在这些设置中,错误的重排甚至不如直接采用第一个样本。CLM的验证延迟分别为79毫秒和32毫秒,相比Jev的449毫秒和131毫秒快4.1到5.7倍,但这更适合说明它是一种高吞吐筛选器,而不是已经证明了普遍可靠的代码审查者。
在工程上,CLM-8B可以放在生成器和执行器之间,先用多个候选扩大成功概率,再用评分器压缩选择成本。候选动作如果长期不变,还可以预先编码并缓存。可是,评分概率不能自动成为安全策略,尤其在工具调用、文件修改或终端操作中,系统仍需定义低置信度时是否拒绝执行、何时重新采样,以及哪些动作必须交给更强模型或人工确认。Apache-2.0的75MB头部和单张NVIDIA GPU、Linux与vLLM的部署条件降低了接入门槛,却没有替团队解决这些策略问题。