
把机制串起来
它不是聊天式生成模型,而是把文本和一份“问题—候选答案—规则” schema 一起编码,再从限定答案中做分类。单标签、多标签和有序分数都能统一表示;输出还可带概率、置信度及约束是否满足。它解决的是路由、分流、审核这类封闭决策,不负责开放问答、解释或真正的长链推理。
编码器同时读取原文、问题描述和候选标签,为每个允许答案计算匹配分数;因此标签集可以在调用时更换,不需要提示词模板或生成答案token。随后约束解码器不把各问题孤立决策,而是在候选组合中搜索满足schema规则的最高分联合赋值。规则可表达蕴含、排斥、基数限制和序数上下界,例如检测到伤害时必须输出unsafe,从而避免各头分别高置信却互相矛盾。代价是解码空间和规则复杂度会随问题、标签及跨头关系增长,且它只能在预先声明的答案空间内选择,不能补充未知答案。与生成式模型相比,它牺牲开放
['适合意图路由、工单分流、审核和工具选择', '需先设计封闭标签与跨问题约束', 'CPU和隔离环境可部署,隐私敏感场景更合适', '不适合开放问答、复杂解释和未知类别发现']
代理系统缺的往往不是生成能力
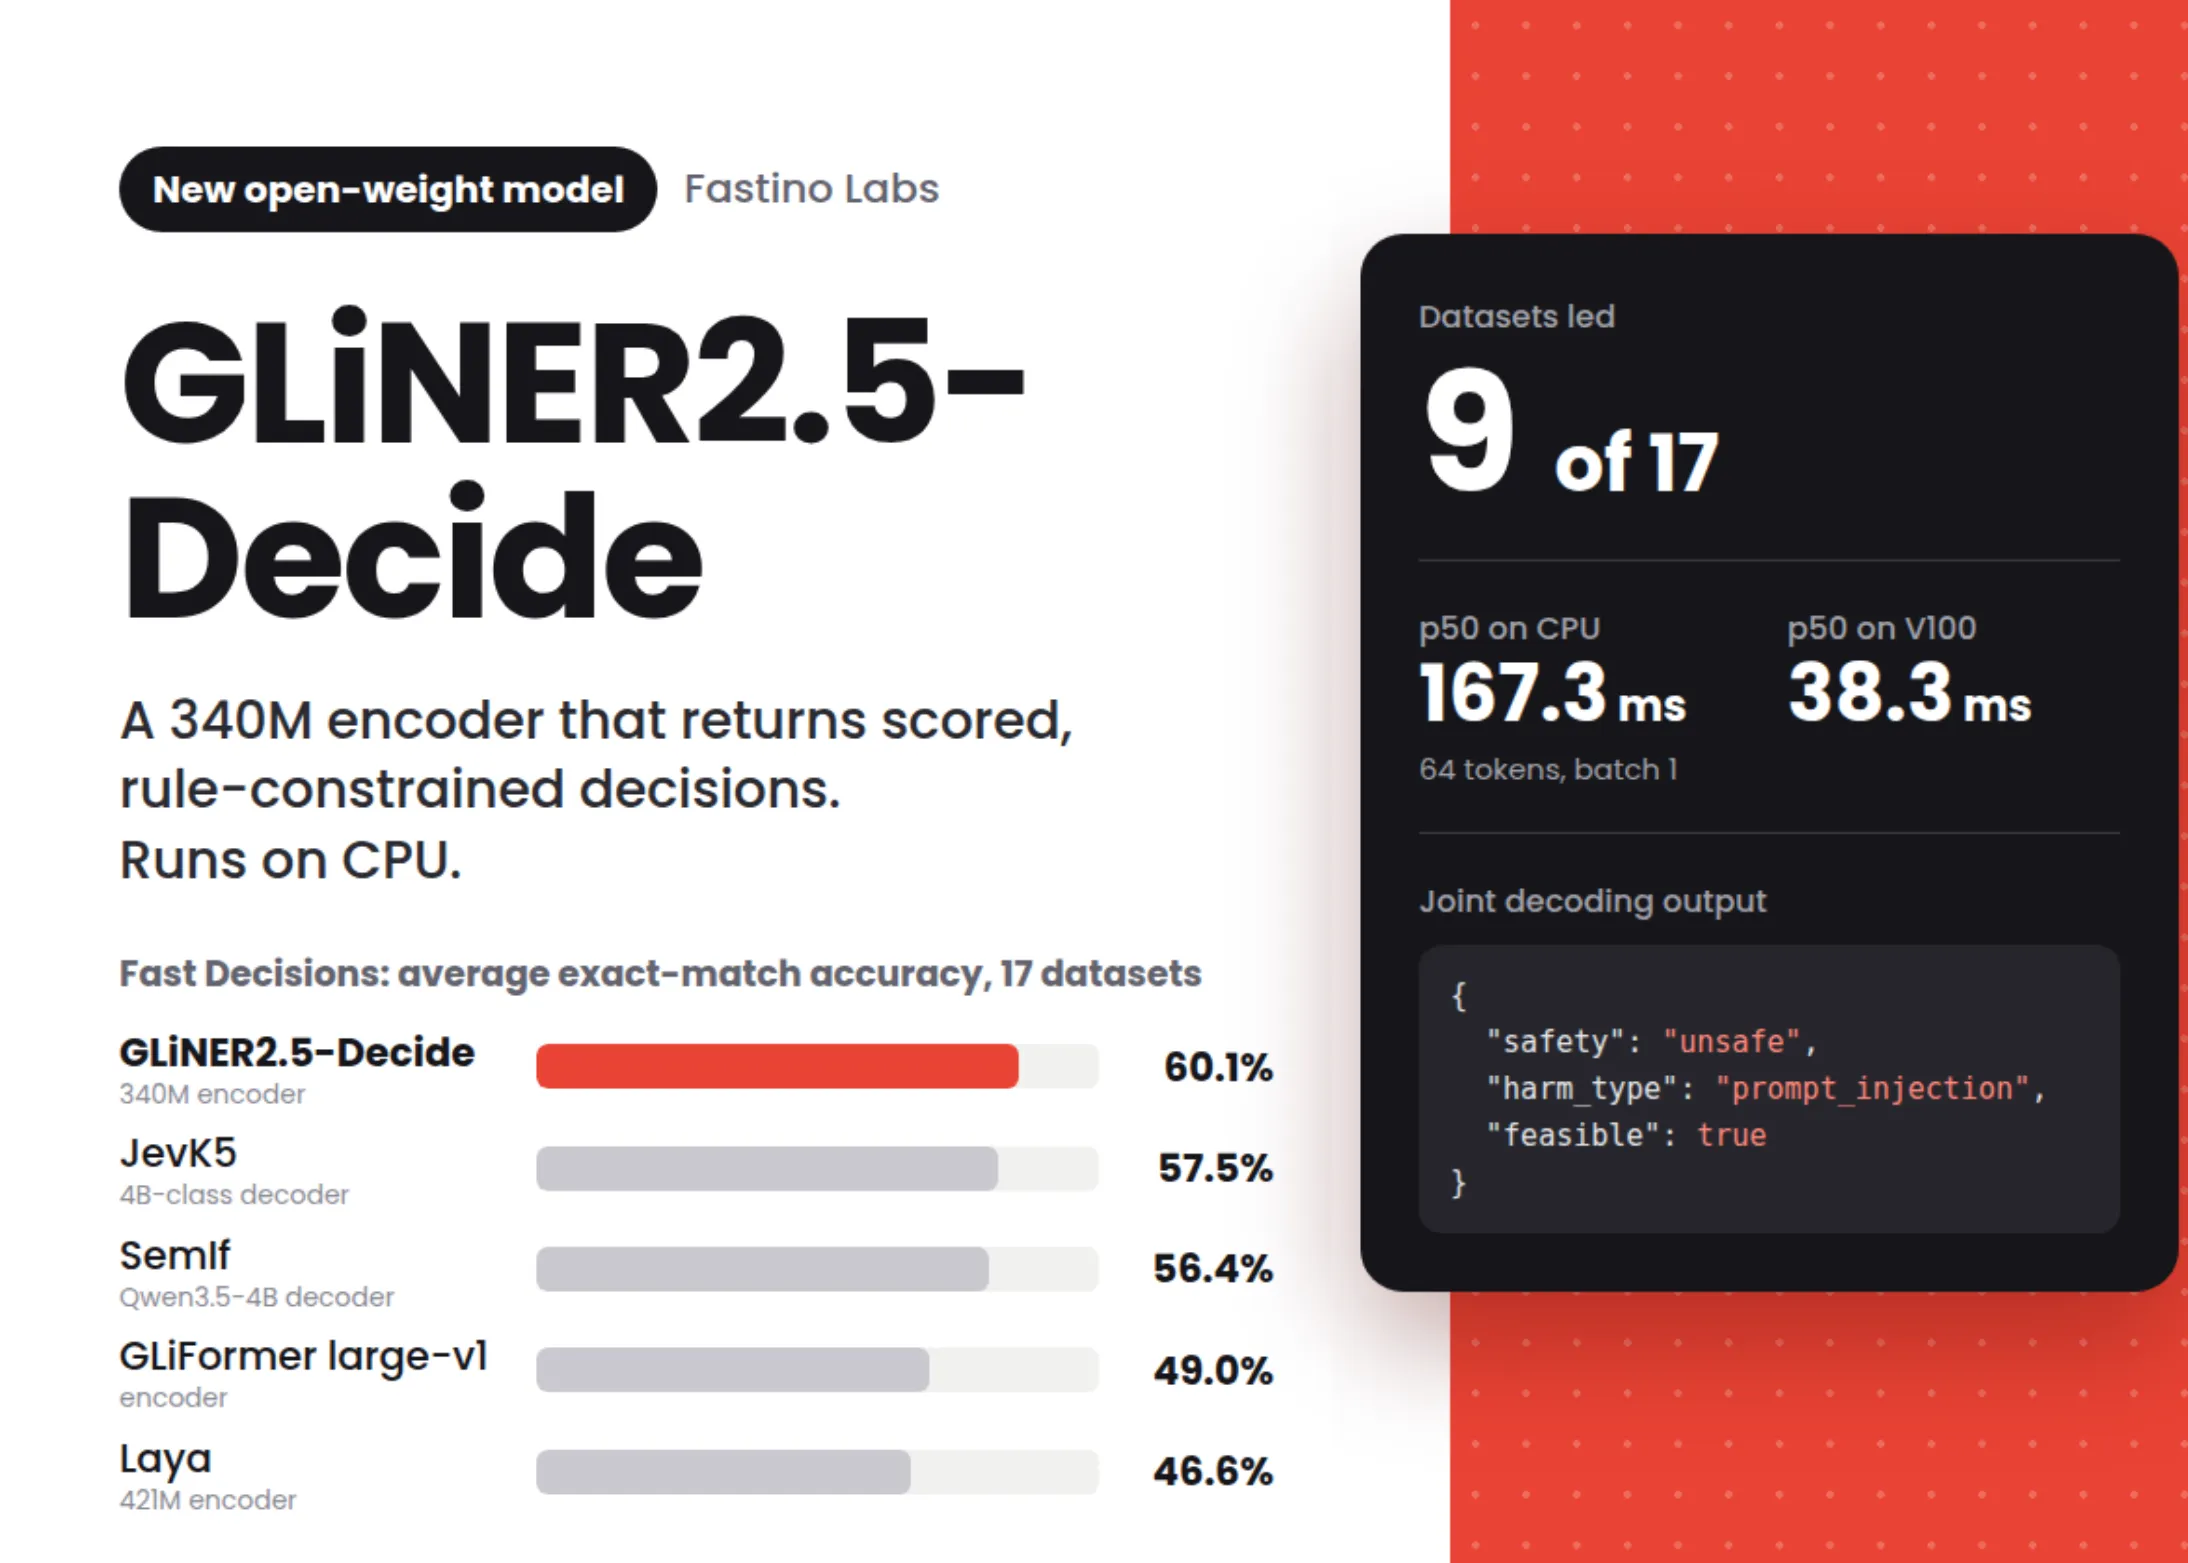
Fastino Labs 发布的 GLiNER2.5-Decide 是一个 3.4 亿参数、开放权重的决策模型。它接收一段文本和一份由类型化问题组成的 schema,然后返回结构化答案,答案附带概率分布、置信度以及约束可行性元数据。它面向的不是开放问答,而是代理流程里反复出现的路由、分诊、工具选择和安全护栏判断。
这一区别改变了问题的形状。许多代理系统并不需要模型写出一段漂亮的解释,而是需要在有限选项中稳定地选择“该交给谁”“是否调用工具”或“是否拦截”。如果这些判断仍由生成模型通过提示词完成,输出格式、标签一致性和规则冲突都要交给下游代码补救。GLiNER2.5-Decide 的方向,是把这一层从文本生成中拆出来,变成一个可以预先声明输入、输出和约束的组件。
核心机制不是更长的提示词,而是联合解码
模型基于 DeBERTa-v3-large encoder,并从 gliner2-large-v1 微调而来。它不生成 token,也不需要 prompt template,标签集合在调用时传入。schema 可以声明每个问题允许的答案、单选或多选形式、顺序值,还可以加入说明、示例、标签描述,以及跨问题关联答案的规则。
推理分为两步。encoder 同时读取文本和 schema,为每个允许的答案打分,随后由受约束的 decoder 搜索满足规则的最高分联合赋值。这个“联合”很关键:材料中的护栏例子显示,独立判断时模型以 0.82 的概率识别出 prompt injection,却又以 0.52 的概率把同一输入标为 safe。加入“发现任何伤害就必须判为 unsafe”的规则后,结果可以同时返回 safety=unsafe 和 harm_type=prompt_injection。系统得到的不是两个需要人工解释的冲突信号,而是一组符合声明规则的决策结果。
它把 schema 变成了代理流程的一部分
这种设计让 schema 不再只是接口文档,而成为决策逻辑的一部分。规则可以表达蕴含关系、互斥关系、基数限制和有序值边界。一次调用还可以处理多个 head,例如同时判断 intent、urgency 和 route。单标签 head 返回一个字符串,多标签 head 则返回超过 cls_threshold 的标签,标签本身还可以携带描述,序数尺度也可以用“0”到“10”这样的普通字符串传入。
对技术负责人而言,这意味着一部分代理编排逻辑可以前移到模型调用的声明层。路由模型不必先生成理由,再由解析器猜测标签;工具选择也可以先通过允许集合和约束筛掉不合法组合。GLiNER 家族还支持在一次 forward pass 中抽取实体、关系和带字符级 offset 的结构化记录,不过材料明确指出,分类答案本身不会返回证据 span。前者适合压缩处理链路,后者则限制了审计和人工复核的方式。
CPU 可部署性改变了它在系统中的位置
GLiNER2.5-Decide 的权重以 Apache 2.0 发布,可通过 pip install gliner2 安装,支持 CPU、GPU 和隔离网络环境。Fastino 也提供托管推理与微调 API。这条部署路径与大模型服务不同:如果一个判断组件可以靠近业务服务运行,团队就不必为每个低复杂度路由都支付远程生成调用的网络和服务依赖。
Fastino 在 batch size 为 1、2 个 head、15 个标签的端到端测试中给出了延迟参考。64 tokens 输入下,48-vCPU Intel Xeon Platinum 8581C 的 p50 为 167.3 ms,NVIDIA T4 为 43.6 ms,L4 为 43.4 ms,V100 为 38.3 ms,A100 为 47.3 ms。到 1,024 tokens 时,A100 为 52.6 ms,V100 为 75.6 ms,L4 为 131.4 ms。短输入主要受固定预处理和 kernel-launch 开销影响,所以几种 GPU 只相差约 9 ms;这也说明“能跑在 CPU 上”不等于所有负载下 CPU 都是更好的选择。
评测支持它做路由器,但还不足以证明它会推理
Fastino 使用自建的 Fast Decisions 留出测试集评估模型,包含 17 个数据集、5,100 个测试样本,覆盖客户运营、银行、临床、旅行、福利等领域路由,以及一般内容理解。指标是 exact-match accuracy,只有预测标签集合与参考答案完全一致才算正确。模型在 17 个数据集中领先 9 个,最强项是意图路由:support intent 得分 75.3%,banking intent 得分 64.3%,分别领先下一名模型 18.6 和 8.6 个百分点。
这些结果足以说明它在特定的固定标签任务上具有实际吸引力,但不能被扩展为通用决策能力的证明。测试集由发布方内部生成,任务覆盖范围也不等于真实生产分布。更重要的是,Fastino 对模型边界的描述很明确:它不推理、不解释,也不回答开放问题。置信度和概率分布可以帮助路由、阻断或升级,却不能自动提供“为什么这样判”的可靠证据。
适合先替代哪一部分,边界又在哪里
更稳妥的接入方式,是把 GLiNER2.5-Decide 放在代理系统的前置决策层,而不是把它当作主模型。可以先用它处理意图路由、请求分诊、工具候选筛选和有明确规则的安全判断,再把低置信度、规则未覆盖或需要解释的样本升级给生成模型或人工流程。这样的架构利用了它的低部署门槛和结构化输出,同时避免让一个不提供证据的分类器承担开放式判断。
最终取舍取决于团队是否能把业务判断写成稳定的 schema。标签集合、阈值和跨字段规则如果经常变化,约束层可能成为新的维护负担;如果真实请求超出预设标签,联合解码也只能在有限选项中给出最可行的答案。因而,GLiNER2.5-Decide 最适合被视为一个可本地部署、可约束、可测量的决策部件。上线前应分别用真实流量校准置信度,测试规则冲突与分布外输入,并为无法返回证据 span 的结论保留升级路径。