
先看证据
先拆开两个经常被混为一谈的概念
MarkTechPost在这篇《GGUF vs GPTQ vs AWQ vs EXL2 vs EXL3》指南中,试图解决一个很实际的工程问题:同一个大模型为什么会同时出现safetensors、GGUF、GPTQ、AWQ和EXL2等不同文件名,而这些名称又为什么不能放在同一张“格式排行榜”里比较。文章给出的关键区分是,容器负责把张量存到磁盘上,量化方法负责把权重压缩到更少的比特中。safetensors、GGUF和PyTorch的.bin或.pt属于前一层,GPTQ、AWQ、bitsandbytes NF4以及llama.cpp的K-quant和I-quant属于后一层。
这一区分会直接改变排障方式。一个GPTQ模型也可能以.safetensors保存,一个AWQ模型同样如此,因此看到文件后缀并不能判断量化算法,更不能判断它适合哪个推理引擎。EXL2和EXL3则更特殊,它们同时包含量化方法与存储布局,并且深度绑定ExLlama这一推理路径。换句话说,工程团队真正需要选择的不是一个孤立的文件扩展名,而是一组权重表示、元数据组织方式和运行时之间的组合。
内存公式能筛选方案,却不能替代部署预算
最粗略的估算是:权重内存约等于参数量乘以每个权重的比特数,再除以8。按材料中的示例,8B模型的16位权重约占16GB,压到约4-bit后约为4.5GB。70B模型则从约140GB下降到约39GB。这种计算足以在项目早期排除明显不可能的硬件配置,却只覆盖权重本身,不包括KV cache和运行时开销。
因此,“4-bit模型能放进某张卡”并不等于服务已经可用。上下文长度、并发请求数量和缓存策略都会继续消耗显存或内存。尤其在多用户服务中,权重只是固定成本,KV cache会随着请求与上下文变化而增长。任何只用文件大小来决定显存规格的方案,都可能在单用户演示时成立,却在真实并发下失效。
GGUF的优势是交付确定性,不只是压缩
GGUF是为GGML及其后继生态设计的二进制格式,典型运行时是llama.cpp。它在2023年8月21日取代GGML,解决的不是单纯的压缩率问题,而是模型文件如何长期携带完整信息的问题。旧格式难以明确标记模型架构,新增超参数还可能破坏既有文件。GGUF改用带类型的键值元数据,让新字段能够加入文件而不必破坏旧的读取逻辑,同时保留单文件部署、内存映射和易加载等目标。
更重要的是,GGUF可以把分词器、特殊token和Jinja聊天模板与权重放在同一个文件中。对Mac或本地设备部署而言,这意味着交付的不只是“能被某个程序读出的张量”,还包括生成对话所需的配套信息,减少了权重、tokenizer和模板版本错配的机会。代价是运行时绑定更明显。材料指出,GGUF在vLLM中的支持仍然有限且高度实验性,需要额外插件,因此它的便携性不能直接等价为高并发服务的吞吐优势。
“4-bit”不是统一的质量档位
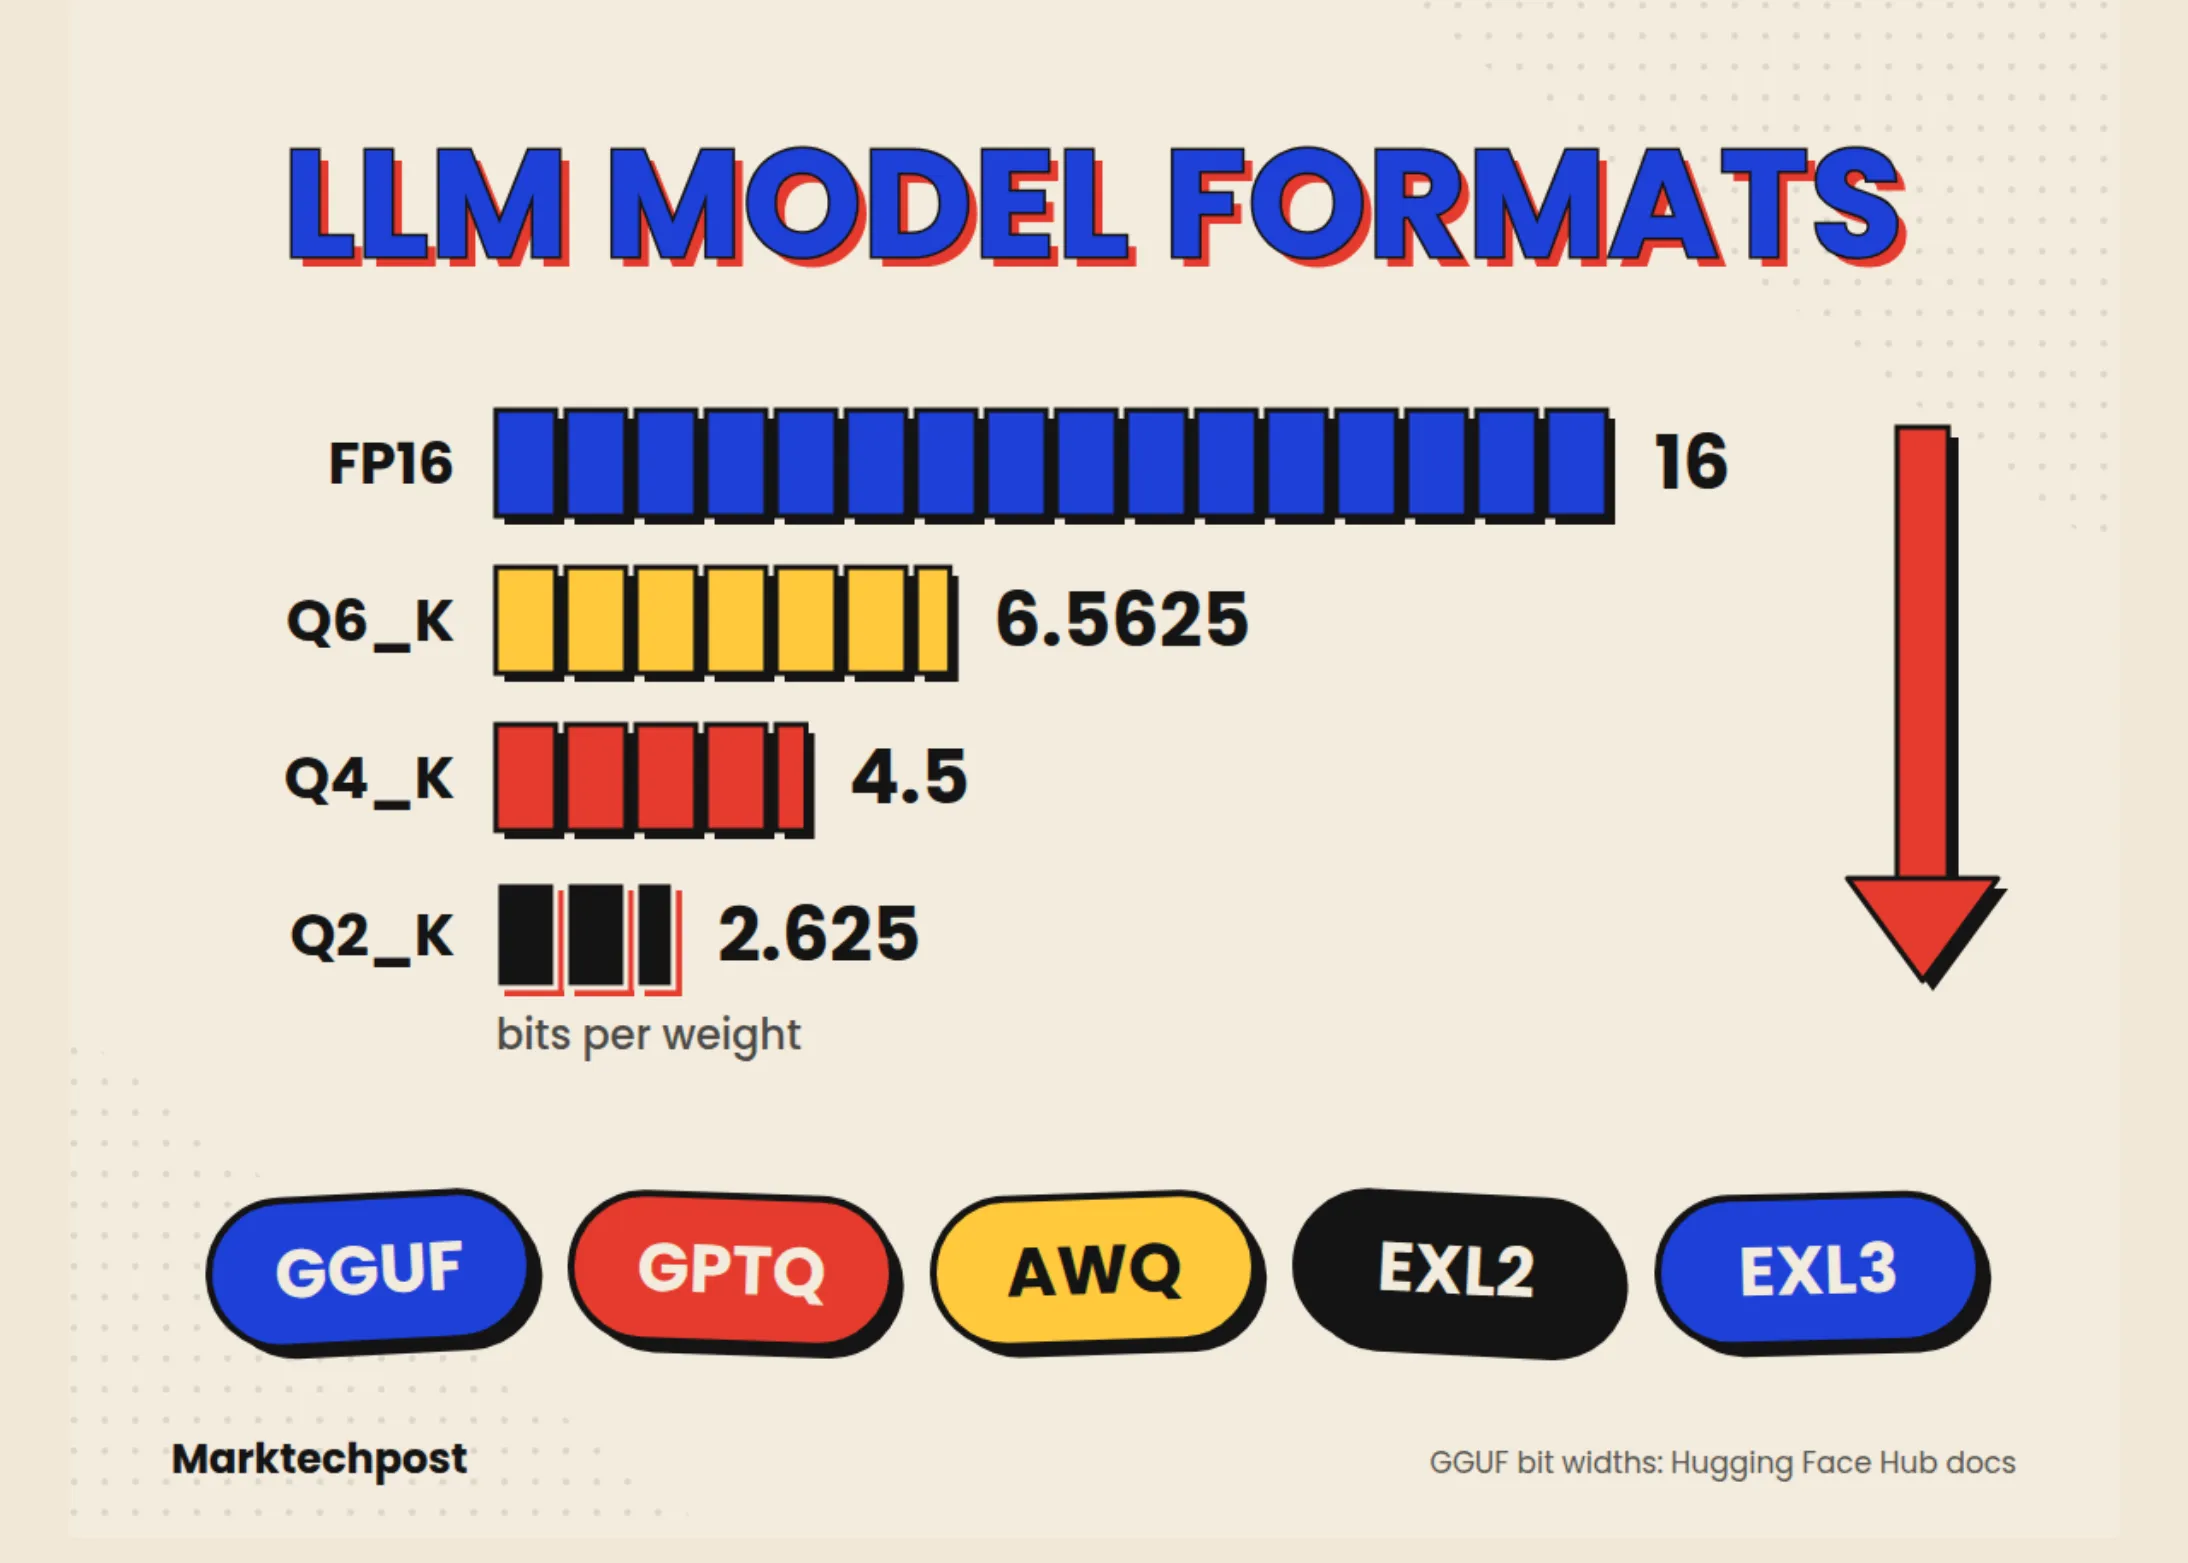
GGUF文件名中的Q4_K_M、Q5_K_M或IQ4_XS,描述的并不是同一种压缩只换了标签。Q4_K使用分块和超分块保存尺度与最小值,平均约4.5 bit per weight。Q4_K_M还会对部分attention.wv和feed_forward.w2张量使用Q6_K,其余部分使用Q4_K,因此它是混合精度方案,不是严格的4-bit权重。I-quant系列则引入重要性矩阵,IQ4_XS、IQ3_XXS和IQ2_XXS在相近的名义位宽下,采用了不同的误差分配方式。
材料给出的Llama-2-7B级别参考表说明了这种取舍:FP16文件约13.0GB,Q8_0约7.0GB且相对基线质量变化约+0.03%,Q6_K约5.5GB、+0.13%,Q5_K_M约4.8GB、+0.39%,Q4_K_M约4.1GB、+1.68%。这些数字只是特定旧模型的示例,不能直接外推到新模型或所有任务,但它们说明了一个重要事实:文件体积、名义位宽和实际质量损失之间并不是一条简单的线性关系。
服务栈不同,最优格式也会改变
GPTQ、AWQ和EXL2/EXL3体现的是另一条取舍路径。GPTQ通过校准和近似二阶信息压缩权重,材料中的研究数据称,175B模型的量化约需4个GPU小时,并报告相对FP16在A100上约3.25倍、在A6000上约4.5倍的端到端加速。AWQ则强调保护约1%的显著权重,材料给出的8B校准时间约为10分钟,相比GPTQ约20分钟。这些结果能说明方法的工程方向,但不应被当成跨硬件、跨运行时的固定性能承诺。
EXL2和EXL3更适合把问题放到单用户消费级NVIDIA设备上重新计算。材料称,EXL3在1.6bpw下仍能让70B模型保持连贯,并可配合4096缓存压进16GB显存,但它要求CUDA 12.4以上,ROCm支持仍在待办。相比之下,GGUF加llama.cpp强调单文件、跨设备和本地部署的便利,GPTQ或AWQ更应放进通用GPU服务栈评估。若目标是多用户、高并发服务,vLLM等高吞吐框架的兼容性和优化程度往往比某个量化文件能否再小几百MB更重要。
实际选型应该从部署路径倒推
如果模型要交付给Mac用户、本地工作站或需要把tokenizer和聊天模板一起封装,GGUF与llama.cpp是一条清晰的评估路径。若目标是消费级NVIDIA显卡上的低显存单用户推理,可以把EXL2或EXL3纳入候选,但必须先确认CUDA版本、客户端成熟度以及是否接受对AMD设备的排除。对于GPU服务,GPTQ和AWQ不应只按“几bit”比较,而要检查目标运行时是否原生支持、校准模型是否匹配,以及并发时KV cache还剩多少空间。
一个可执行的决策顺序是:先确定设备和运行时,再估算权重、KV cache与运行时开销的总预算,随后在同一模型、同一任务和同一上下文条件下比较质量与吞吐。不要把safetensors误认为未量化,也不要把Q4_K_M、AWQ 4-bit和EXL3 4-bit当作同一种产品。格式选择的边界很明确:如果运行时不支持,最小的文件也没有部署价值;如果只验证了权重能装入显存,却没有验证缓存和并发,所谓的容量结论也还没有完成。