
变化先发生在架构边界,而不是榜单上
Kyutai发布了Voice of Reason的两个9B开源权重语音到语音模型。它们都建立在GLM-4-Voice-9B之上,目标是直接听懂口述数学题并用语音回答,流程中没有语音转写步骤,也没有独立的文本大模型接管推理。对需要实时交互的语音助手而言,这绕开了级联系统的一个根本问题:ASR、文本推理和TTS每增加一层,就可能增加等待时间,也会丢掉语气等副语言信息。
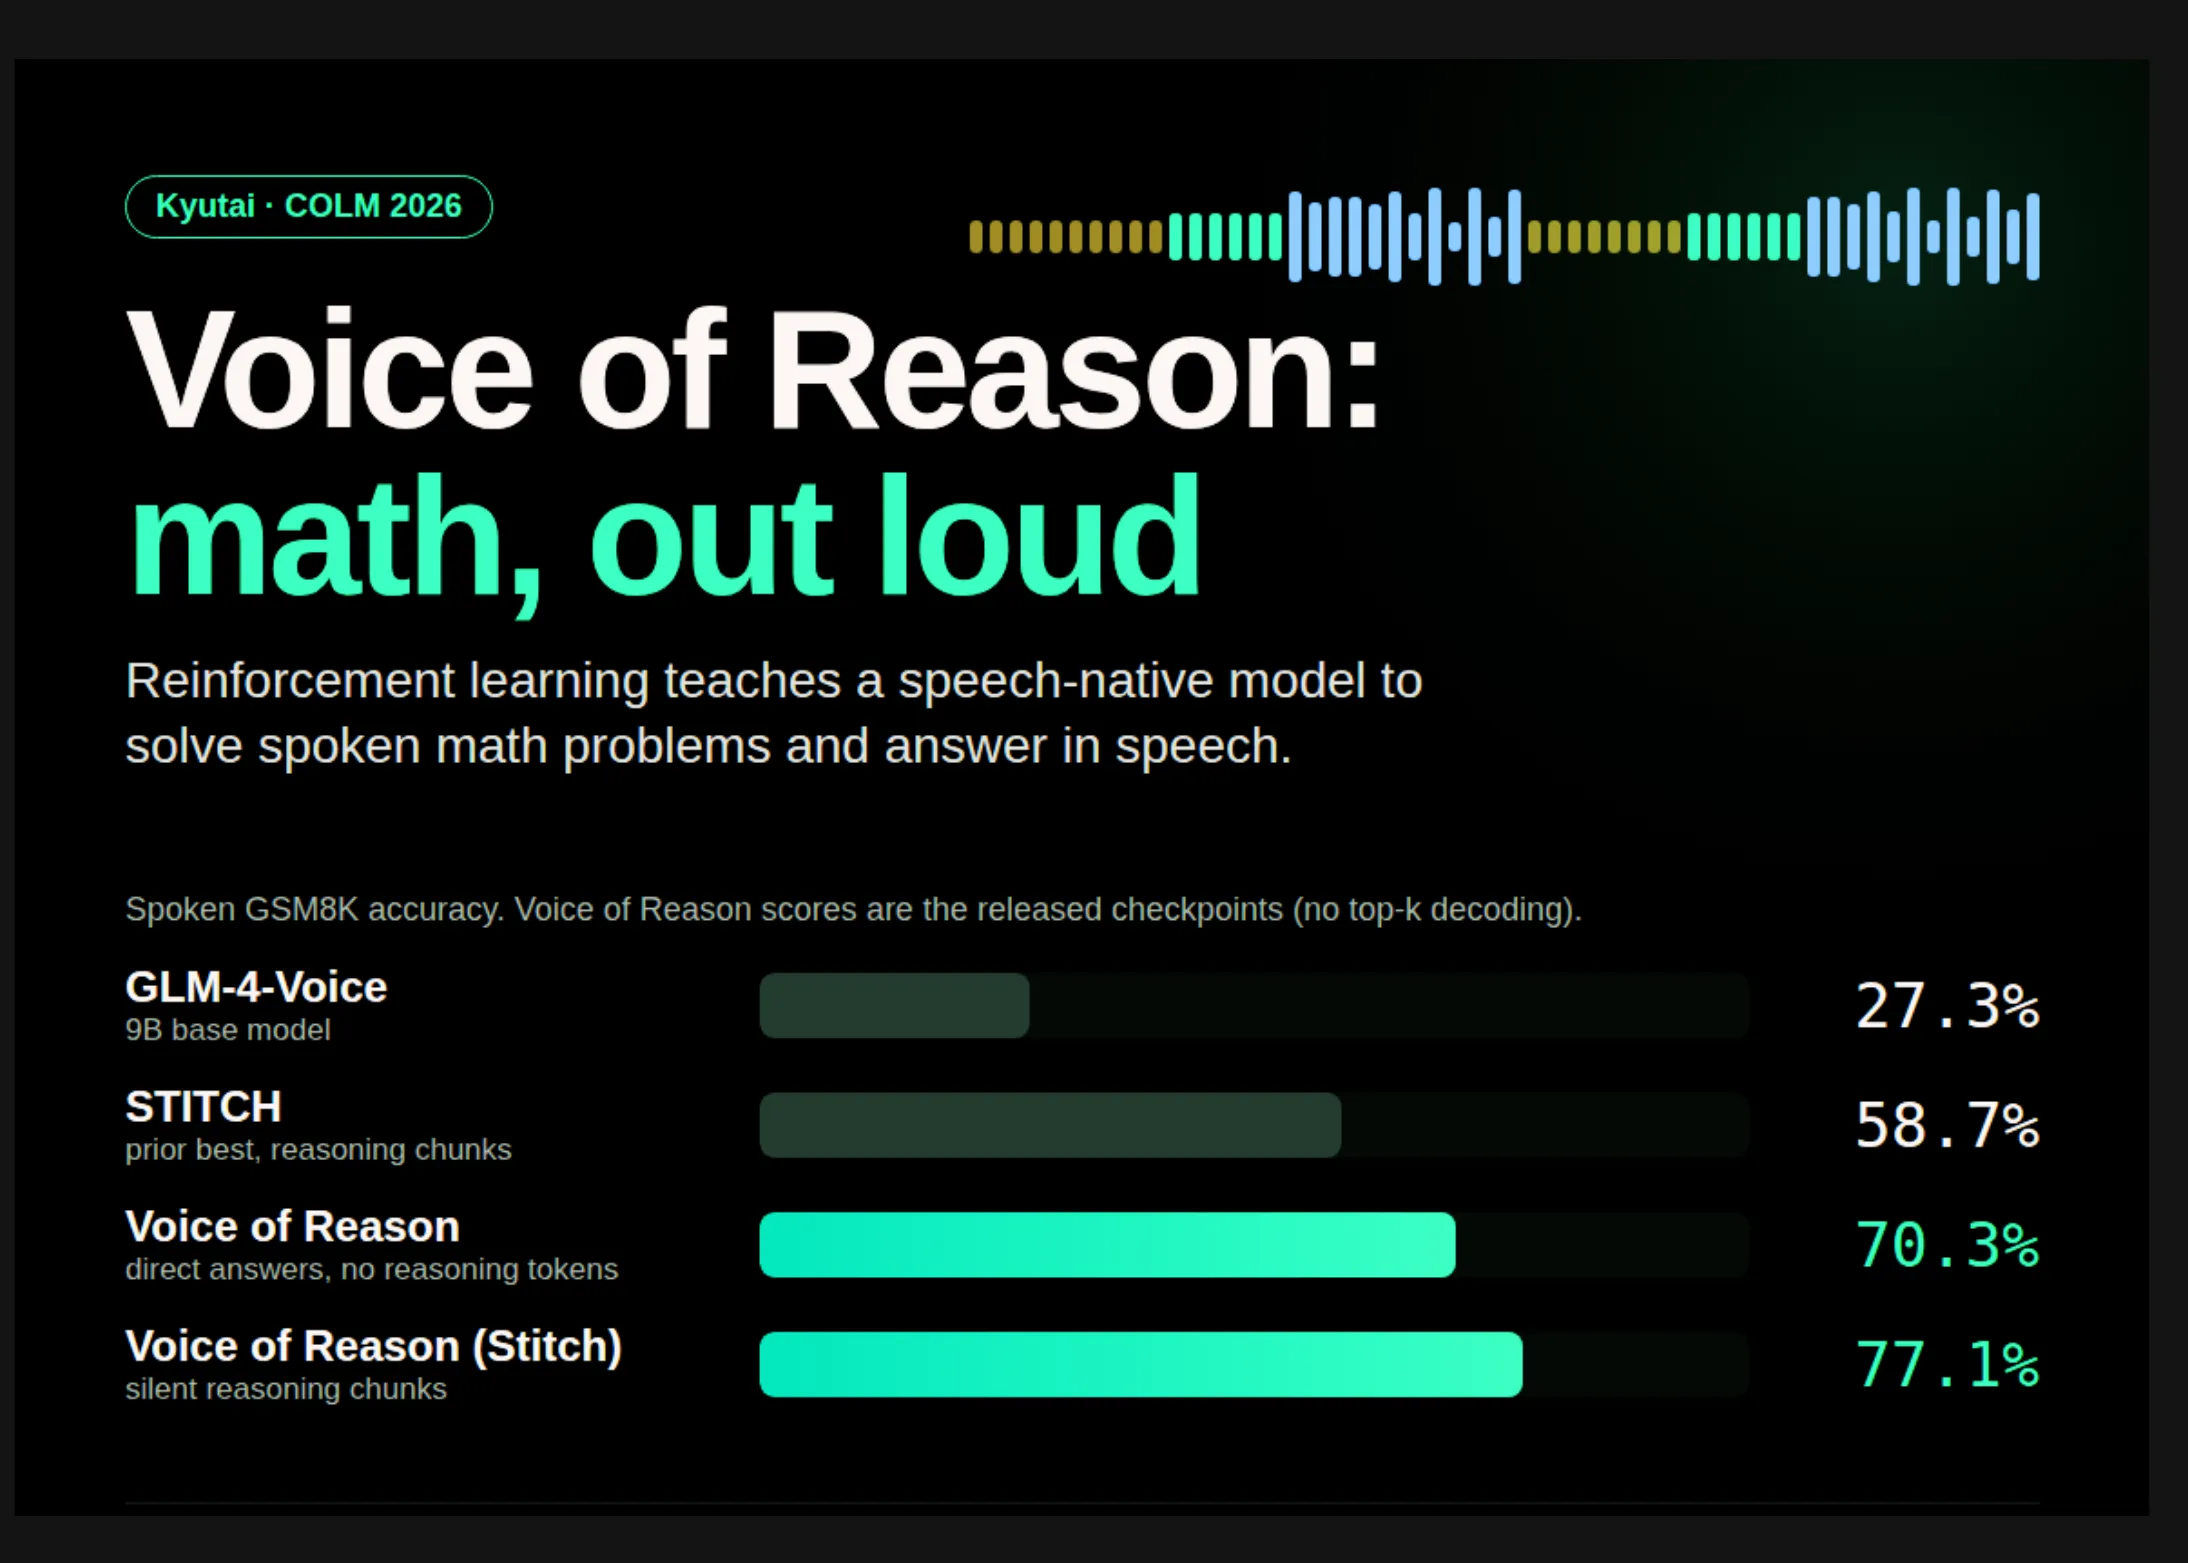
这次发布值得读,不是因为它已经取代了级联方案,而是因为它把“语音模型为什么不会推理”改写成了一个可训练的问题。GLM-4-Voice基座在spoken GSM8K上的准确率只有27.3%,此前STITCH方法加入推理块后达到58.7%。Voice of Reason继续沿着这条路线加入监督微调和强化学习,说明能力缺口并不只来自模型规模,也来自模型是否被训练成能够在持续发声的约束下组织答案。
模型一边说话,一边受到输出格式的约束
GLM-4-Voice不是先生成完整文本再合成语音,而是交替生成13个文本token和26个音频token。这个设计让模型能够持续输出声音,却也限制了它可以用于内部推理的空间。语音模型必须定期交付音频,不能像纯文本模型那样长时间只生成不可见的中间token,然后一次性给出答案。
Voice of Reason的两个检查点正好体现了这组取舍。直接模型在语音中把解题过程说出来,发布评测达到70.3%,研究结果中的对应准确率为65.5±1.1。STITCH版本则在语音块之间插入100个不会被说出的推理token,发布评测达到77.1%,研究结果为74.8±1.1。Kyutai的设计是让后续推理块在前一段语音播放时生成,因此增加思考并不必然增加首响之后的交互等待,但它也意味着系统必须协调隐藏计算、音频播放和流式调度。
真正的训练突破来自奖励如何进入语音模型
第一阶段是监督微调。Kyutai使用Orca-Math的150,616道题,由Qwen3-235B改写成适合口述的形式,再用DSM TTS生成多种声音。SFT把基座模型的spoken GSM8K准确率从27.3%提高到61.7%,这一步已经说明,语音化题目、回答格式和示范数据本身就能大幅改变模型行为。
第二阶段才是语音原生强化学习的关键。对于每一道语音题,模型在温度0.9下采样4个回答,Qwen3-235B-A22B-2507读取解码后的文本流,只给出正确或错误的二元奖励,而且不查看参考答案。奖励在同一问题的回答组内进行中心化,再用于组相对REINFORCE目标。这个判分器在100个人工核验样本中与人工判断一致88次,训练则使用16张H100完成1,500次更新。它证明的是奖励不必依赖转写后的文本模型作为推理主体,而可以直接塑造语音模型的输出行为。
两个细节决定了强化学习是否有效
这套训练并不是把通用RL流程简单移植到音频token上。一个关键修正是温度校正:模型以温度0.9采样时,损失计算中的logits也必须除以同一温度,再进入log-softmax。材料显示,缺少这一修正,GSM8K准确率会从65.5%跌到12.3%,说明采样分布和训练目标不一致时,奖励信号会迅速失真。
另一个处理针对音频词表。每个音频位置并不要求模型学习具体是哪一个音频token,而是把整个音频词表的概率加总为一个抽象的“音频到来”事件,损失只判断此处是否应该生成音频。研究给出的结论是,在价值函数对具体音频token不敏感的前提下,这种估计既无偏又能降低方差。对工程负责人而言,这个细节比“用了强化学习”更重要:当输出空间同时包含文本和音频时,奖励设计、采样分布和动作粒度会共同决定训练能否稳定。
可部署,但还不是开箱即用的语音基础设施
Voice of Reason的工程门槛比论文中的“开源权重”更具体。两个BF16检查点都可以在单张H100上运行,但部署还需要GLM-4-Voice仓库中的语音tokenizer和decoder。当前没有Hugging Face推理服务托管这些权重,因此使用方需要自行准备GPU、推理链路和语音解码组件。对自托管的研究团队来说,这已经是可操作的条件,对希望快速接入产品的团队来说,却仍是一条完整的系统集成任务。
性能数字也必须放回正确的边界。77.1%不能直接与文本模型或级联系统横向比较,因为材料明确指出,对比系统在规模和架构上并不匹配。真实语音转写评测的准确率为72.0±1.9%,而语音TriviaQA从40.6%降至34.0%,显示数学专项后训练可能牺牲通用知识能力。工程上更稳妥的判断是:如果目标是低延迟数学辅导、受控问答或需要保留语音交互特征的助手,可以评估STITCH式静默推理和端到端训练。如果目标是开放域知识问答、广泛语言任务或低GPU成本部署,级联方案仍然更容易做能力隔离、替换和治理。