
视频 DiT 的瓶颈,已经不在一个算子里
视频 Diffusion Transformer 会把一段视频的空间和时间 token 展平成一条长序列,再在每一层执行全量自注意力。一个 5 秒、720p 的 Wan2.2-14B 片段约有 7 万个 token,注意力的成本还会随序列长度平方增长。在一次 MiniMax-H3 测试中,单张 B200 使用 BF16 FlashAttention-4 时,每个去噪步骤约三分之二的时间都花在注意力上。
低比特 Tensor Core 已经可以加速注意力中的两次矩阵乘法:QK 和 PV。但这并不意味着整个注意力模块都以低比特运行。两次矩阵乘法之间的 Softmax 仍使用 FP32,指数计算和随后将结果转换为 FP8 的过程,在 H200 和 B200 上反而可能成为最长的流水线阶段。VC-Attention 的出发点因此不是单纯把 8 bit 再压到 4 bit,而是同时处理精度误差和低比特硬件没有覆盖的 Softmax 阶段。
Value 才是被低估的误差源
既有低比特注意力方法通常先处理 Query 和 Key,通过平滑或旋转减轻离群值。但在 Wan2.2 的分析中,即使 Q/K 已经处理,Value 仍贡献了 82% 的输出误差。Value 的离群 token 没有稳定的通道或时空位置,直接旋转它也没有解决问题:旋转 V 带来的误差变化只有 0.2%。
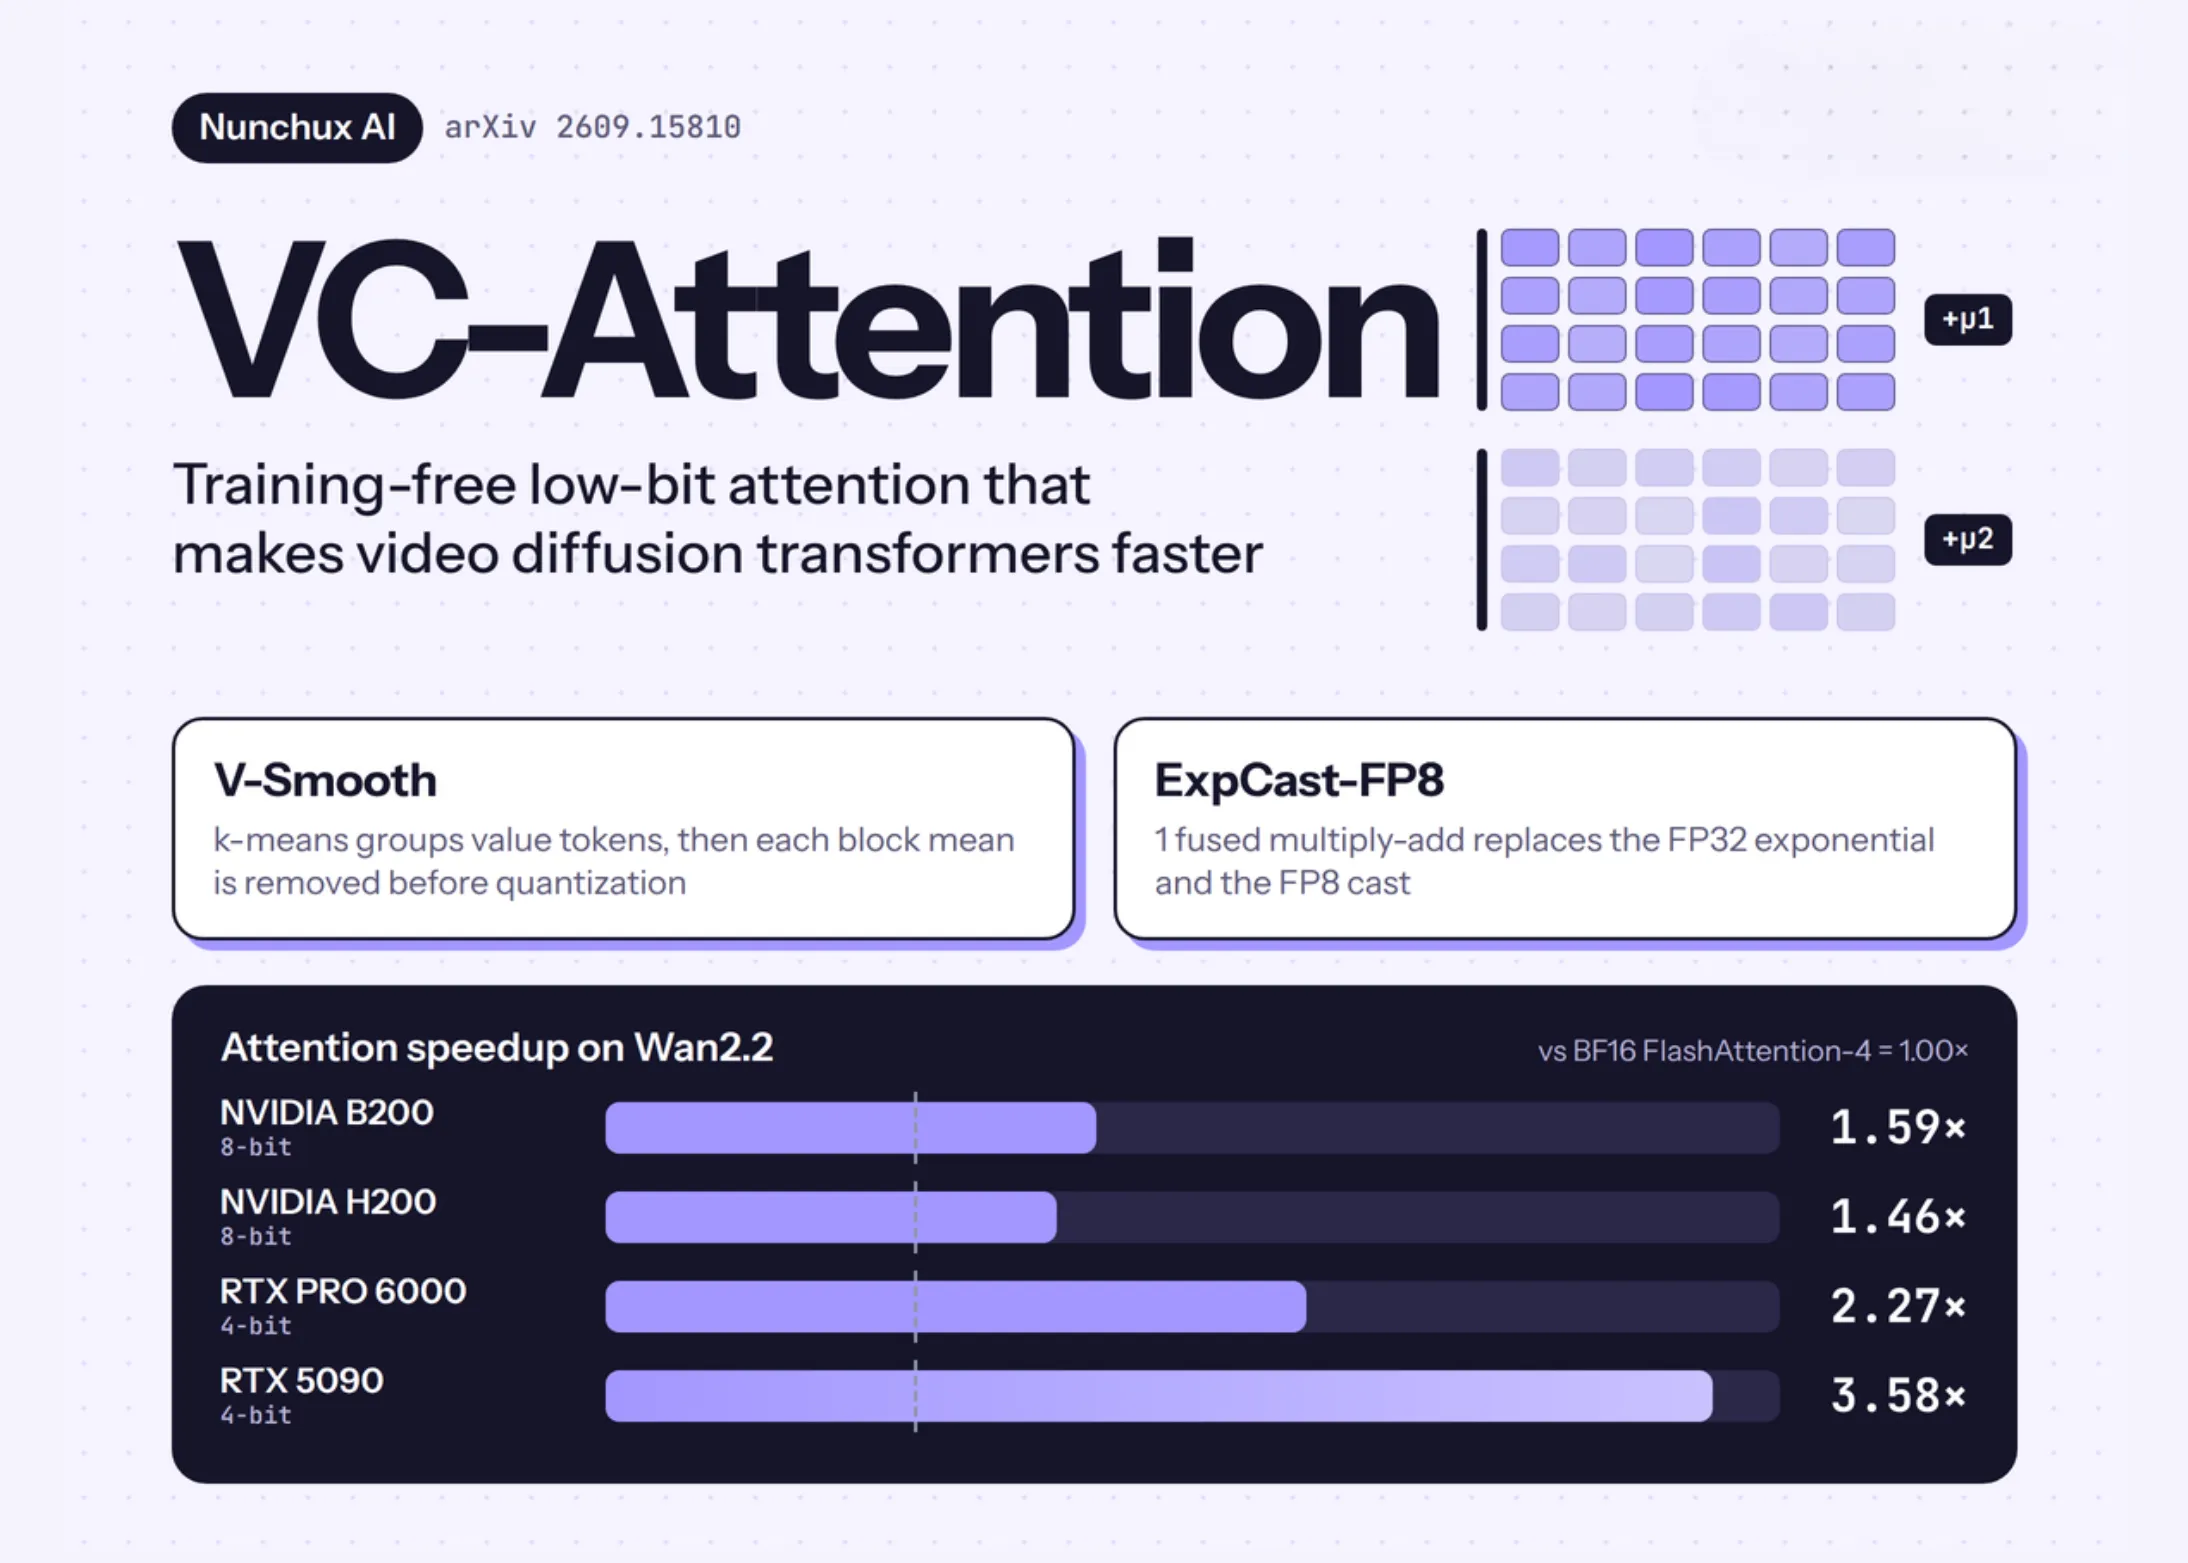
V-Smooth 采取的是数据重排,而不是继续寻找一种固定旋转。它在每个 batch 和 attention head 内在线聚类 Value token,再把相近的 token 排到同一组。每个 128-token 硬件块先减去自己的均值,只对残差做量化,8 bit 路径使用 E4M3,4 bit 路径使用 NVFP4。块均值并没有被丢掉,而是借助在线 Softmax 已经维护的行和恢复,因此不需要第二次遍历或额外缓冲。
这个设计的关键不是均值本身,而是把统计校正塞进了已有的 Softmax 状态。按序列顺序分块时,块均值平均移除约 8% 的块能量;经过排序后,这一比例达到 36%。代价是每个值元素增加 0.125 bit 的均值存储,以及在线聚类带来的计算开销。
Softmax 也必须进入低比特设计
VC-Attention 的另一半是 ExpCast-FP8。E4M3 字节存储的数值接近对数域表示,因此内核可以把对数域分数直接映射成 FP8 概率编码,用一次融合乘加替代 FP32 指数运算和格式转换。资料显示,这条直接路径在每个数值加倍区间的 79.6% 范围内会写出与传统路径相同的字节,其余位置通常只相差一个编码值。
这不是无条件的精确替代。报告给出的逐行总变差上界低于 3.64%,在 204.8K 个 Wan2.2 attention row 上测得的平均值为 1.6%。更重要的限制是,ExpCast-FP8 只适用于 8 bit 路径。NVFP4 没有对应的单一仿射对数到编码映射,因此 4 bit 并不能同时获得这项 Softmax 加速。
V-Smooth 也不是免费预处理。聚类只在去噪前 25% 的步骤运行,并在连续 4 个步骤之间复用排列,平均仍占注意力时间的 3% 到 4%。在 B200 上,手写的 CuTe/CUDA 融合将一次 V-Smooth 调用从 42.2 毫秒降到 4.8 毫秒,说明实现质量本身就是这套方法能否成立的一部分。
最高的内核倍数,不等于部署收益
报告相对 BF16 FlashAttention-4,在数据中心 Blackwell 和 Hopper GPU 上给出的注意力内核加速为 1.46 到 1.59 倍,在工作站显卡上则为 2.3 到 3.6 倍。端到端视频生成的提升明显更小:数据中心 GPU 约为 1.13 到 1.19 倍,工作站显卡约为 1.36 到 1.70 倍。一个 RTX 5090 测试中的注意力内核最高达到 3.58 倍,但端到端只有约 1.70 倍。
这个差距是架构判断的核心。完整生成流程还包含其他算子、去噪步骤和数据搬运,注意力只占其中一部分。GPU 上已有的基线内核也会改变比较结果:资料指出,SageAttention2 在 B200 上没有 Blackwell 专用内核,而是使用面向更早 GPU 的实现。因此,“比某个基线快多少”不能脱离硬件、基线成熟度和注意力占比来解释。
对技术负责人而言,VC-Attention 更像一个可验证的后端候选,而不是拿来即用的通用加速开关。它适合先在长序列视频 DiT 上做端到端基准,分别比较 8 bit 与 4 bit 路径、聚类开销和输出质量,再决定是否值得替换现有注意力内核。当前资料还没有公开可直接部署的 kernel,也没有解释其暂不开源的技术或商业原因,这些都应被视为落地前的边界,而不是用宣传倍数填补的空白。