

先看证据
把机制串起来
遥感嵌入可以理解为把一段卫星观测压缩成一串可复用的数字特征:下游任务通常只需拿少量标注训练一个小模型,而不用每次都重新处理原始影像。光学影像能反映地物光谱特征,但常受云影响;雷达观测不依赖可见光,能补充不同的地表信息。把多时相、多传感器信息压进年度表示,目标是既保留地表差异,也降低后续任务的算力和数据门槛。
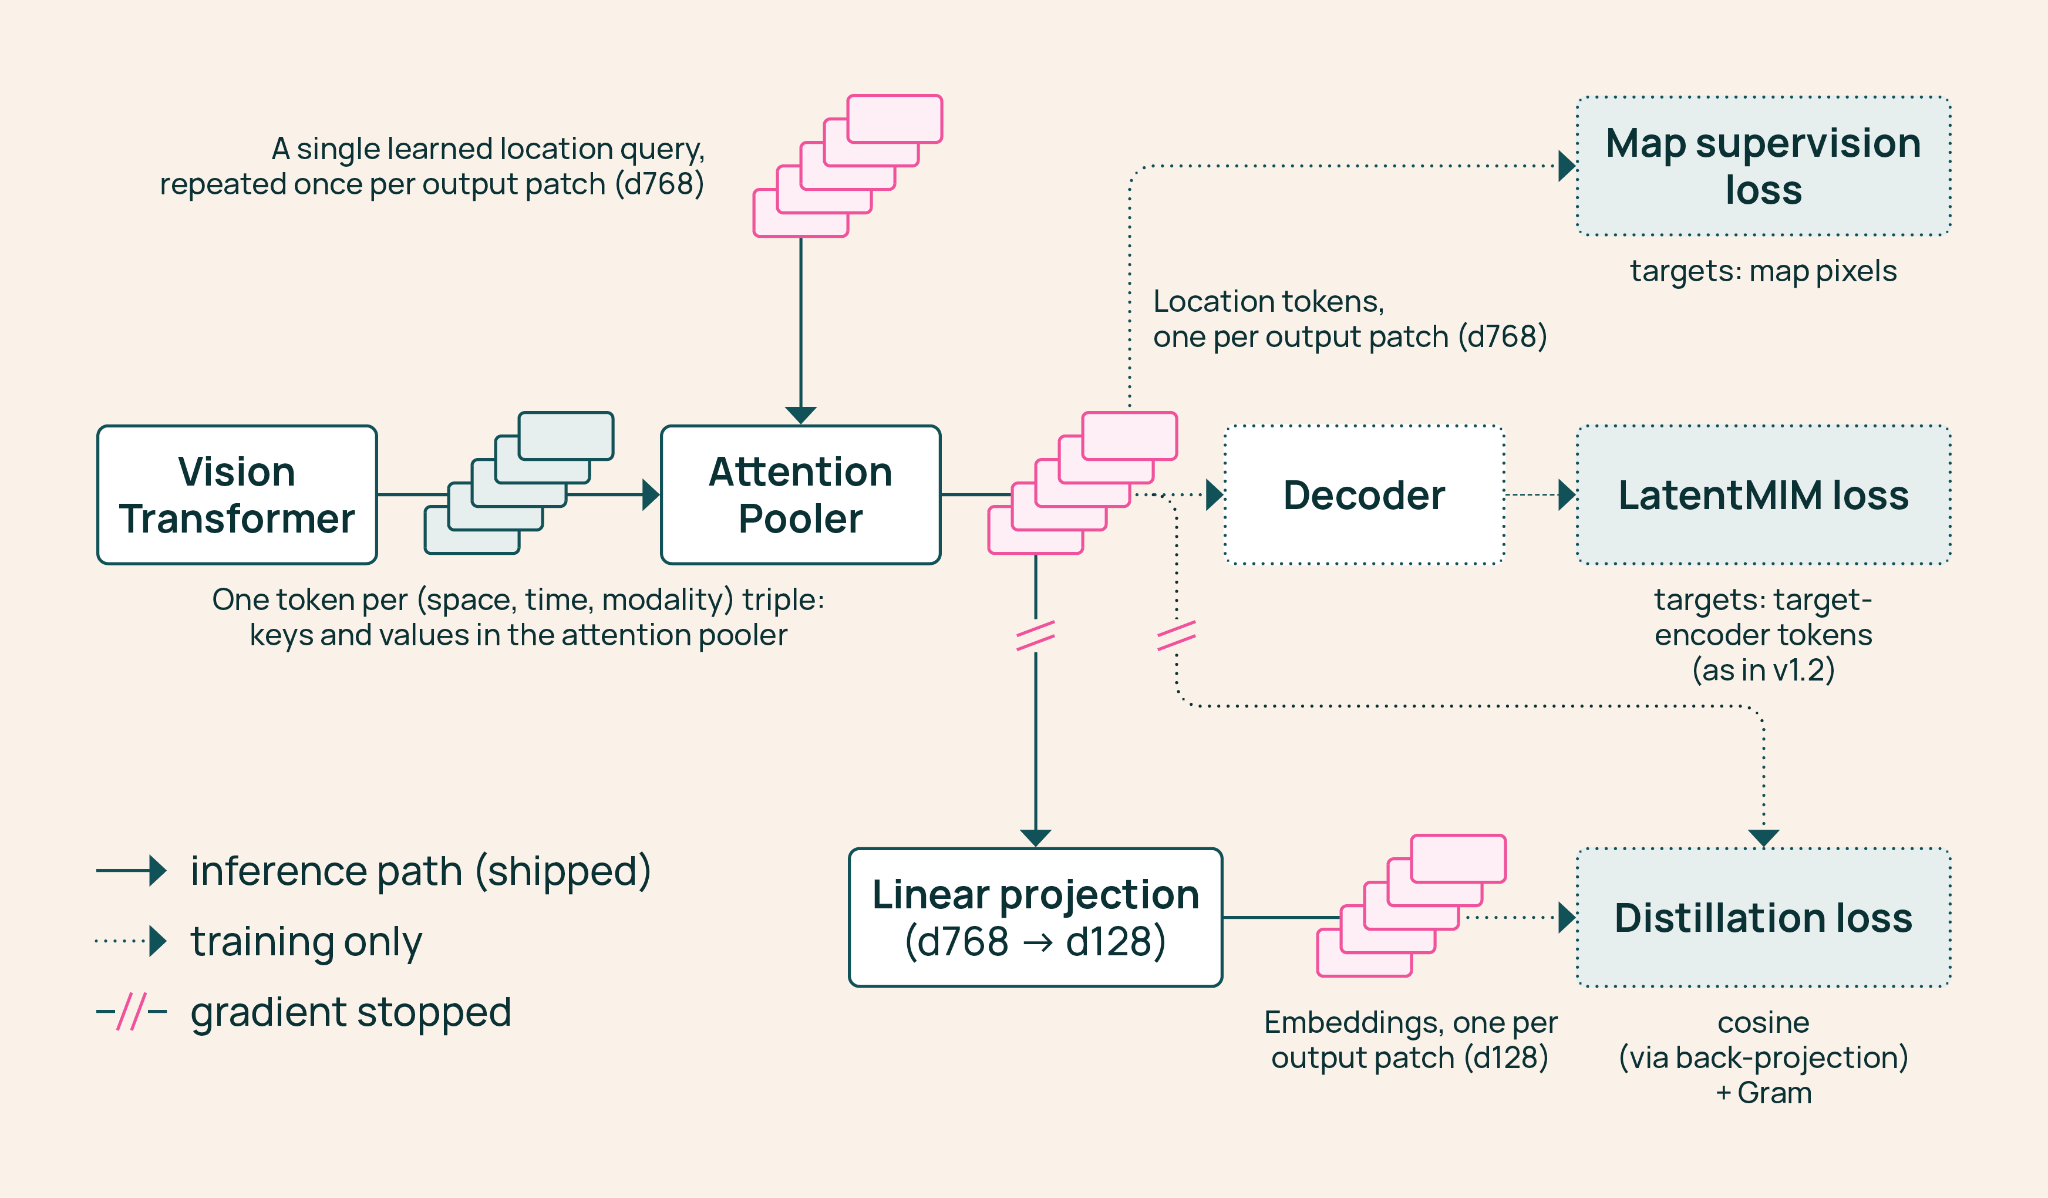
模型读取 Sentinel-1 雷达、Sentinel-2 与 Landsat 光学影像的年度时序;全球发布数据按每年 12 个、每个 30 天的时段合成影像。视觉 Transformer 编码观测,Attention Pooler(模型卡中对应 Perceiver 组件)汇聚时空信息,再由线性投影把 768 维内部表示压到 128 维,形成每个 10 米像素的年度嵌入。训练采用遮蔽影像建模,让模型利用未遮蔽内容重建被遮部分,并预测地图目标,从而学习可迁移的地表表示。Matr
['适合已有少量标签、想快速做地物分类或变化分析', '可先用64维做原型,再按精度需求切换128维', '年度嵌入适合年度制图,不适合追踪月内突发变化', '验证目标地区迁移效果;PLANTEUR留岛成绩低于随机划分']
全球嵌入改变了使用模型的入口
Ai2 发布的 OlmoEarth v1.3,是一个把卫星影像时间序列编码为特征向量的模型;同时开放的还有全球年度嵌入数据,以及浏览器工具 OlmoEarth Embeddings Explorer。它面向的不是单一制图任务,而是希望从卫星数据中识别地表类别、变化或相似地点的用户。此前,OlmoEarth 的主要路径是在 Studio 中针对具体任务微调,再把模型跑过影像,这要求使用者有 GPU,也要处理影像的下载和存储。
v1.3 的变化,是把基础模型计算提前做完:使用者可以直接从已经计算好的嵌入开始,为自己的任务训练较小的模型。Ai2 提供全球数据,意在让用户不必先取得并运行整套卫星影像流程;浏览器工具则提供一种无需登录、无需高级技术背景的探索入口。这不是让遥感分析不再需要工程,而是把第一道门槛从“能不能跑基础模型”移到了“手上的表示和标签能不能回答问题”。
一个年度向量,压缩了多源时序信息
OlmoEarth v1.3 读取 Sentinel-1 雷达、Sentinel-2 与 Landsat 光学数据的年度时序,为地球上每个 10 米像素生成一个 128 维向量。前 64 维也能独立使用,因此数据使用者可以在较小表示和完整表示之间选择。技术报告描述的流程是:视觉 Transformer 编码不同时间、不同传感器的数据,Attention Pooler 将信息汇聚成地点表示,再由线性层把 768 维内部表示压缩到 128 维;Matryoshka 学习让前 64 维也保有独立用途。
这套设计的关键,不只是把图像变成更小的数据,而是让同一份表示可以服务多个下游任务。预训练使用遮蔽图像建模,让模型根据可见影像重建被遮部分,并预测地图目标;发布的全球年度数据则以每年 12 个 30 天时段合成影像为基础。用户不必为每个任务重新运行基础模型,但也继承了年度汇总和固定表示的边界:如果任务需要更细的时间变化,或特定的信息没有被嵌入保留下来,轻量分类器无法凭空补回这些内容。
基准成绩强,但不是对所有任务的保证
Ai2 将 v1.3 与 AlphaEarth Foundations 和 Tessera v2 放在 27 项评估中比较,覆盖六大洲和多种任务。按发布方报告,128 维嵌入在 20 项评估中得分最高,64 维版本在 18 项中得分最高,且整体排名领先。这说明压缩到一半维度并未在这组评估里抹掉大部分竞争力,但“赢了多少项”仍是特定数据集和任务集合上的结果,不等同于对任意地点、任意制图目标都更准。
新作物类型基准 PLANTEUR 尤其能说明泛化问题的重要性。技术报告给出的 mIoU 是:128 维版本在随机划分上为 36.7,在留一岛测试(LOIO)上为 24.9;64 维版本分别为 35.2 和 21.5。随机划分和留出地点的结果并不相同,意味着模型在已见区域附近表现如何,不能替代对新区域的检验。Ai2 称 v1.3 在未见地点上的作物类型泛化最佳;实际部署仍应按目标地区和目标类别单独验证,而不是把整体排名当成上线结论。
把基础模型成本前置,也把工作转移给使用者
全球预计算嵌入的工程价值,在于把昂贵的一次性计算摊给许多潜在任务。Ai2 称,v1.3 的训练用时约为 v1.2 的 53%、v1 的 18%,碳排放分别约为两代旧模型的 50% 和 22%;技术报告还估算,复现 v1.3 Base 最终预训练运行需约 2,720 美元的 H100 租用费用。这些数字描述的是训练效率和一次运行的估算,不代表使用全球嵌入没有存储、读取或后续标注成本。
对下游团队而言,流程可以变成:选定地点与年度嵌入,准备与任务匹配的标签,训练小型分类器或回归器,再把结果制成地图。材料列举的用途包括肯尼亚小农作物分类、达卡以西砖窑检测、印度尼西亚火灾损害评估,以及秘鲁亚马孙地区金矿开采追踪。对于不想下载整套原始影像、又需要快速试验多个地图任务的团队,这种入口可能明显降低启动成本;但任务标签、空间划分和结果核查仍是团队自己的责任。
适合快速建模,不等于免除遥感判断
OlmoEarth v1.3 的权重、预训练数据和代码均开放,全球嵌入也已提供给社区;模型仍可用于微调,Ai2 称其在研究和合作方标签上的表现与 v1.2 持平。因此,嵌入路线不是取代所有原有工作流,而是增加一种复用表示的选择:当任务适合从固定年度特征中学习时,先训练小模型可能更经济;当任务需要不同时间窗口或任务特定表征时,微调路线仍有价值。
技术负责人在采用前应先问三个实际问题:年度合成是否符合所需的时间尺度,64 维是否足以满足存储与精度要求,评估划分是否真正模拟了部署时的地理迁移。浏览器探索器可以帮助发现模式,却不能替代标签质量检查或现场验证;全球覆盖也不意味着每个地区、类别都有同等可靠的结果。更稳妥的判断是把嵌入视为可复用的起点,而不是现成答案:它能省去重复运行基础模型的部分成本,却不会替团队决定地图需要表达什么,以及错误会带来什么后果。