
先看清这组看似矛盾的数字
Ringg是一家面向企业的语音与聊天智能体平台,起点是印度大型消费业务的客服场景。它把智能体部署到电话、聊天、WhatsApp和网页渠道,帮助客户完成购买保险、预约、查询账户和处理服务请求,而不只是回答一条知识库问题。OpenAI发布的案例称,Ringg目前每月处理超过700万次接通通话,智能体最高可解决65%的请求,客户平均CSAT为4.8。
这组指标真正值得技术负责人拆开的地方,在于“使用GPT-5.6”并不等于“所有请求都由GPT-5.6处理”。Ringg表示,GPT-4.1仍承担大部分实时语音和聊天流量,适合的实时负载从GPT-4.1迁移到GPT-5.6后,模型成本约降低90%。所以这里发生的变化不是一次简单的模型替换,而是客服系统开始把模型选择本身当作运行时决策。
客服请求不是一个任务,而是一条流程
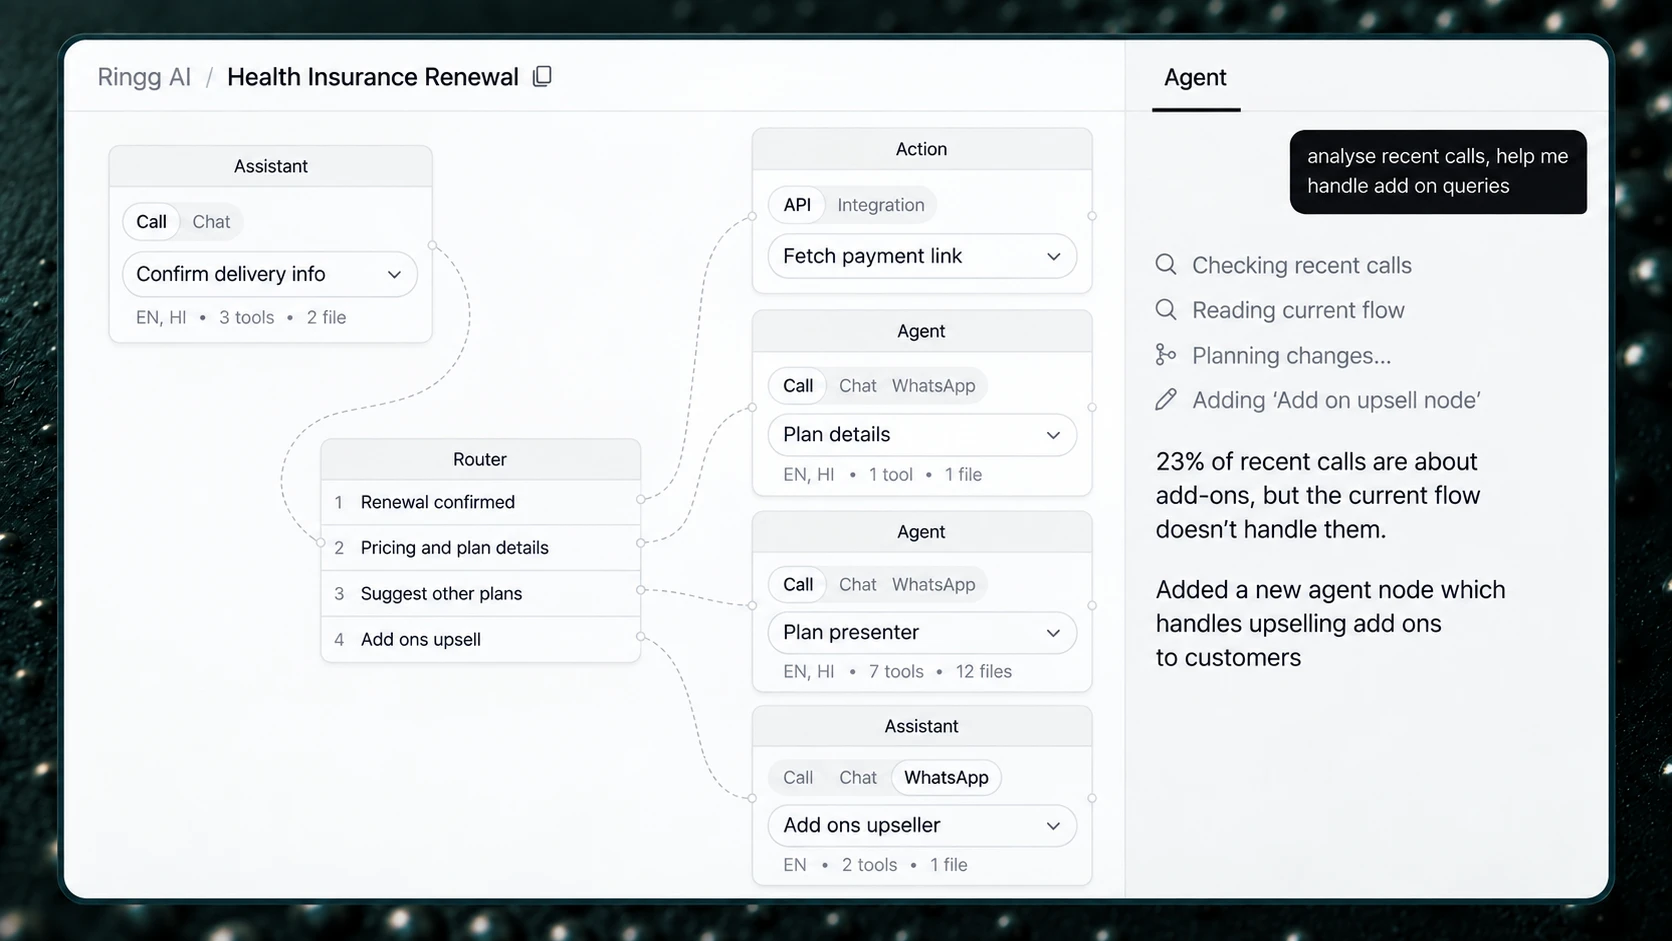
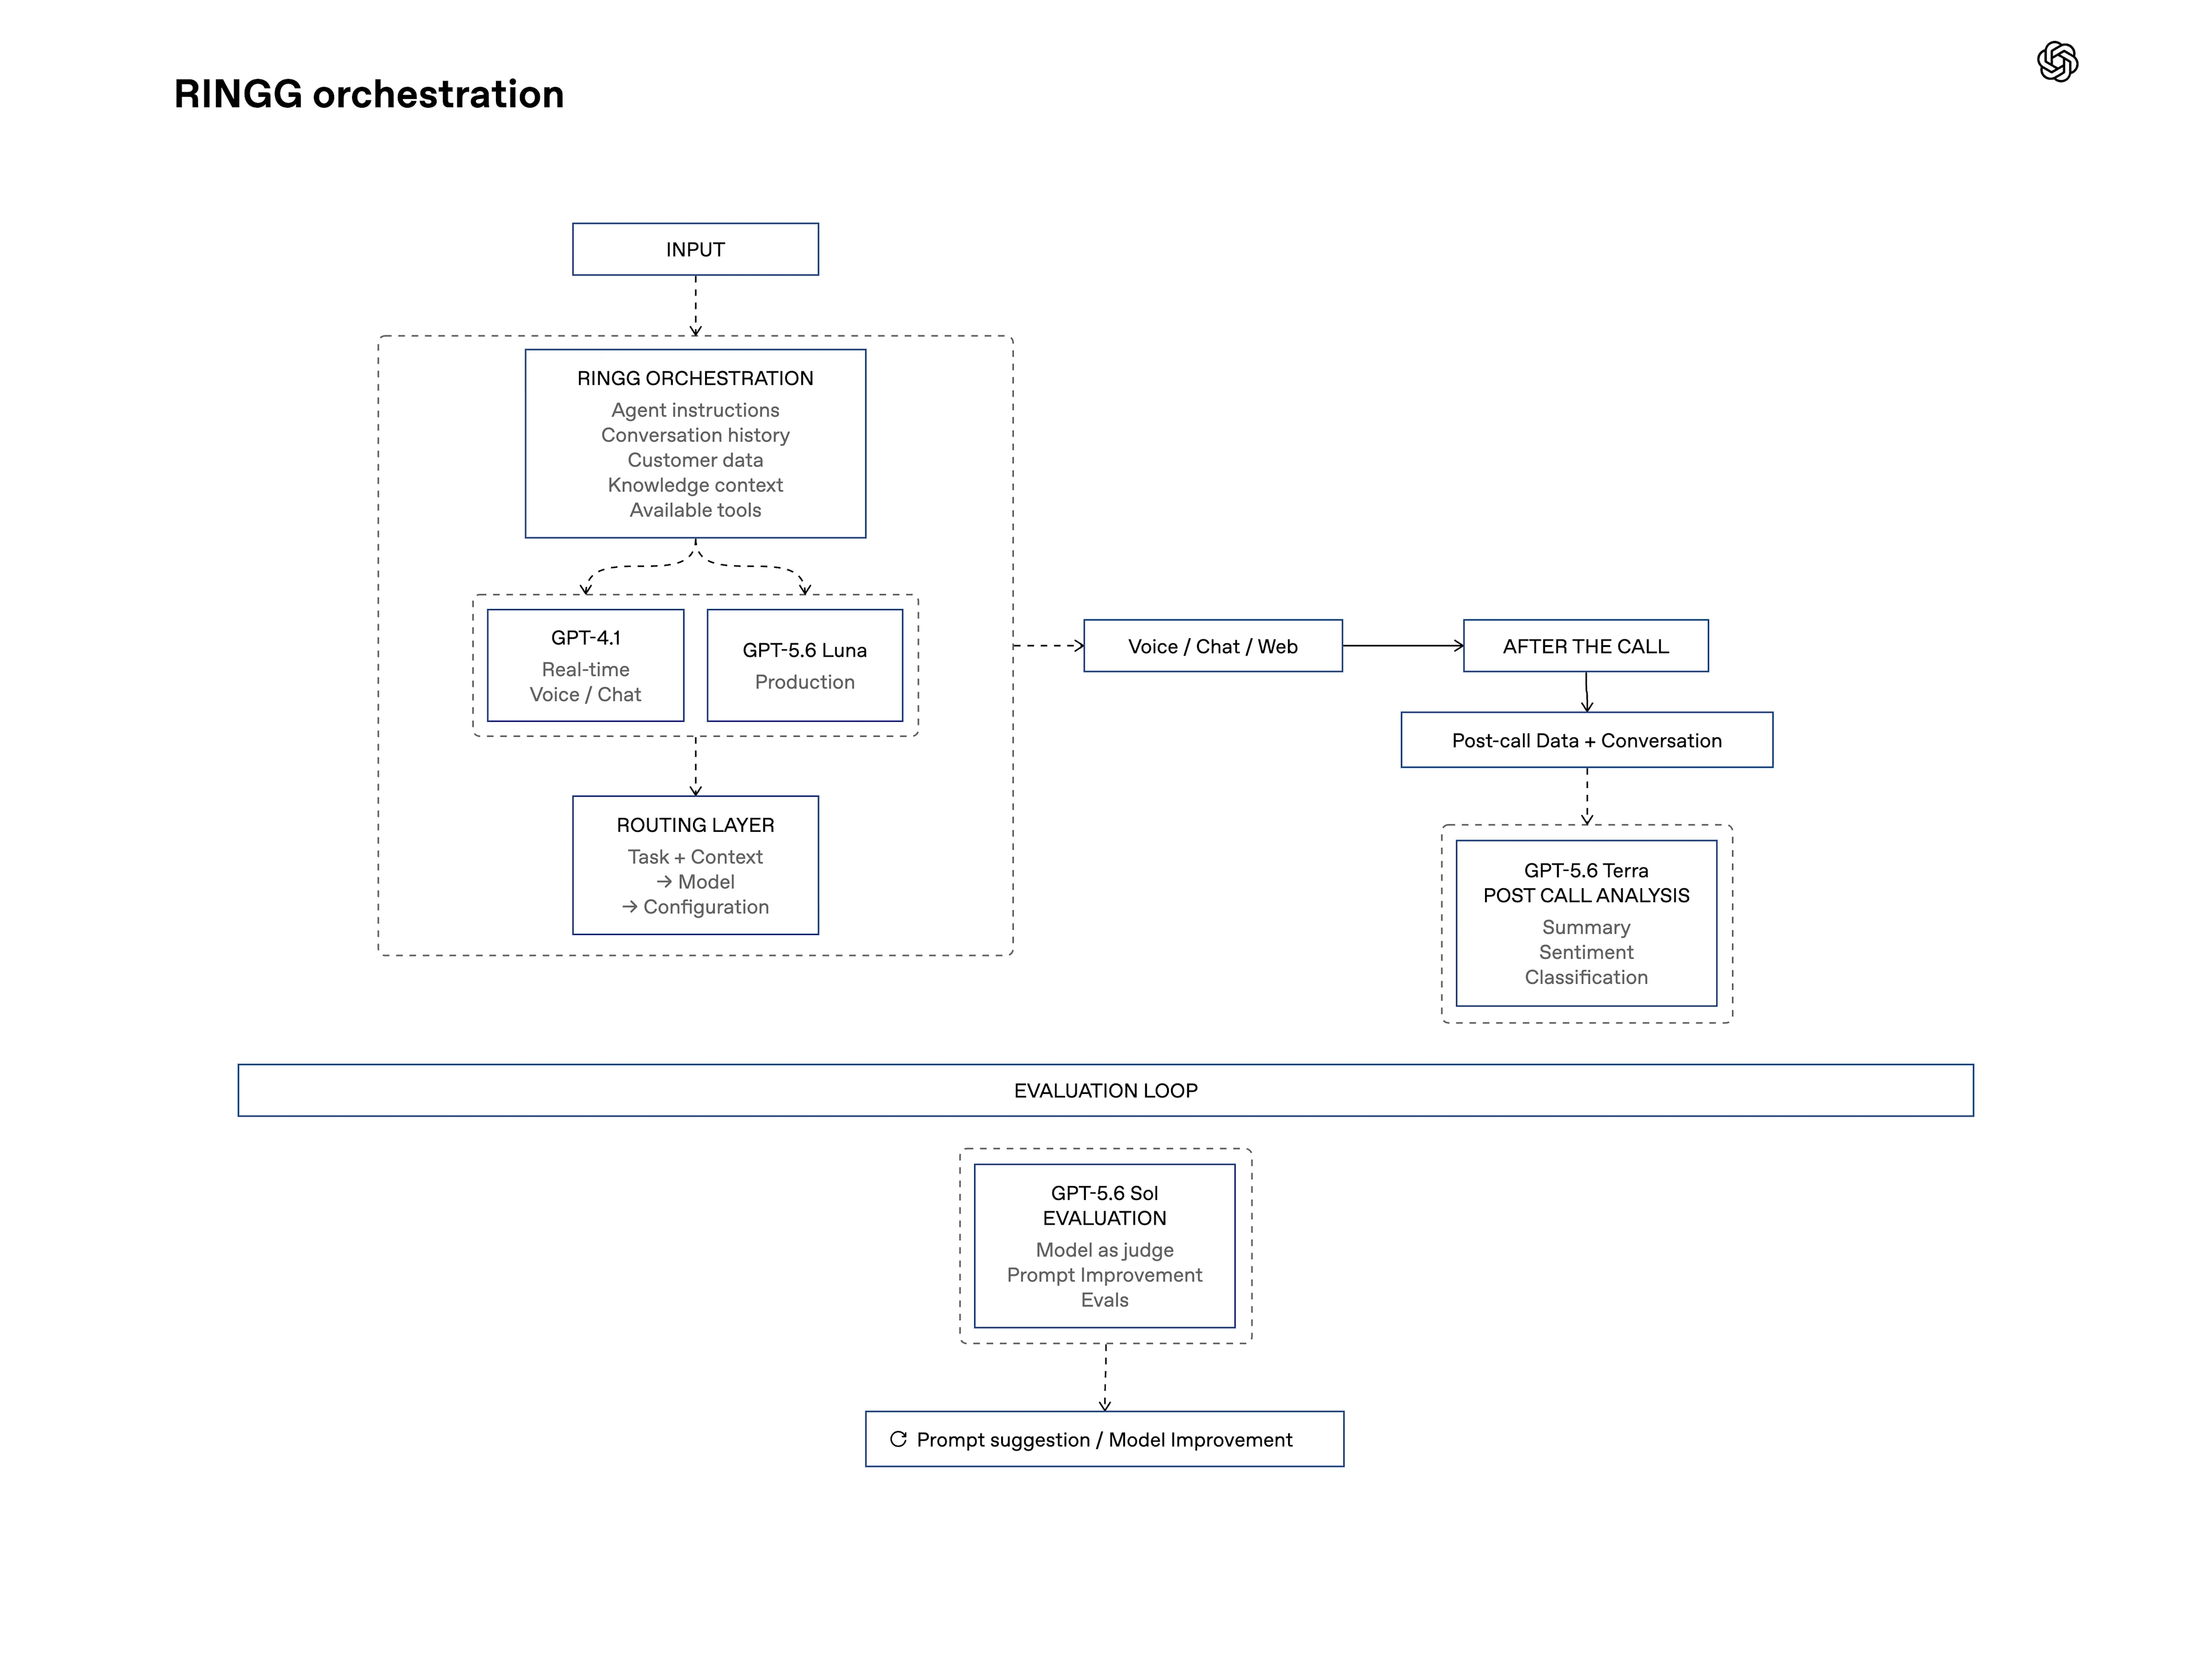
Ringg的编排层把用户输入、会话历史、客户数据、企业知识和可用工具组合起来,再交给模型判断下一步动作。一个看似普通的请求,可能需要查询保单、读取账户记录、安排时间、更新CRM、调用支付系统,或者在无法自动完成时把对话转给专业人员。智能体的输出因此不只是文本,还必须能触发外部系统中的动作,并把动作结果重新带回对话。
这也解释了为什么知识检索和工具调用比模型名称更接近客服系统的核心能力。Ringg的知识系统可以在结构化数据、PDF、CSV和业务文档中做过滤与语义检索,编排层则连接CRM、工单、支付、排班和内部API。对于更复杂的流程,平台还可以把资格审核、支持、验证、排班和升级拆给不同子智能体,再由上层系统维持同一段客户对话。
证据块|这套架构的闭环由四个动作组成:先理解请求,再检索企业信息,随后执行工具操作,最后在自动完成或转人工之间做决定。人工升级时,Ringg会保留会话摘要和相关上下文,而不是让客户从头解释问题。
模型路由解决的是单位任务经济学
Ringg把不同模型放在生产系统中的不同位置。GPT-4.1主要负责实时语音和聊天,GPT-5.6 Luna在性能、延迟或价格性能更合适时参与生产请求,GPT-5.6 Terra负责通话后的摘要和情绪分类,GPT-5.6 Sol则用于评测、提示词改进和模型评审。这样做的前提是,实时对话、批量分析和质量评估的约束并不相同。
这种分工改变了模型采购的比较方式。Ringg评估模型时不只看对话质量,还同时看延迟、指令遵循、工具调用、多语言能力、可靠性和成本。对客服平台而言,一次请求的成本不应只按输入输出token计算,还要看它是否成功完成任务,是否需要重试,是否把错误交给人工,以及是否能在客户仍在线时完成。
证据块|案例给出的三个边界必须同时保留:90%的成本下降只针对合适的负载,65%是“最高”请求解决率,4.8是平均CSAT。它们分别对应成本、自动化覆盖率和客户体验,不能合并成“模型升级后客服整体降本90%”这样的结论。
规模化的瓶颈从回答质量转向系统运营
当客服请求从单轮问答变成跨系统任务,系统可靠性就不再由模型单独决定。编排层必须知道哪些工具可以调用,知识检索必须返回足够相关且适用的业务信息,路由层必须在延迟和成本失控前选择模型,交接机制还要让人工坐席理解智能体已经做过什么。长对话接近约8万token时,Ringg会生成结构化摘要,这说明上下文管理本身也是生产系统的一部分。
Ringg提供的部署案例说明,价值主要出现在高频、流程相对固定、结果可以核验的工作上。材料中的Policybazaar案例称,Ringg连接了超过5.7万个客户请求,其中67%的通话无需人工介入,平均响应时间从8至12分钟降到60秒以内。另一个Practo案例称,首次通话解决率达到85%,响应时间低于3秒,预约流程每天完成超过1000次。它们展示的是任务闭环带来的运营改善,不是一个通用的模型能力排名。
对技术负责人而言,最值得复用的不是某一个百分比,而是评测对象的改变。应该按业务流程建立成功标准,分别记录工具动作成功率、人工转接率、端到端延迟、每次解决成本和客户满意度,再用灰度流量观察模型与提示词调整是否改善整体结果。只盯着单轮回答的准确率,无法发现“回答正确但没有完成预约”这类系统性失败。
65%解决率的边界,比65%本身更重要
Ringg的案例并没有证明客服岗位可以被完全替代。65%使用了“最高”这一限定,且平台仍然保留向专家转接的路径,说明自动化覆盖率取决于请求类型、业务数据质量、工具权限和风险容忍度。保险、支付或账户变更等流程,即使模型能理解客户意图,也不意味着系统就应该拥有无限执行权限。
因此,采用类似架构时,切入点应该是高频、可验证、可回滚的流程,而不是先追求一个统一的自动化比例。企业需要先定义哪些动作允许智能体直接执行,哪些动作必须二次确认,哪些情形只能交给人工,并为每次交接保留可审计的上下文。模型路由可以降低单位成本,但不能替代权限设计、异常处理和责任归属。
Ringg案例最稳妥的判断是:客服Agent已经从“会不会回答”进入“能否在约束下完成任务”的阶段。对已有客服系统,优先建设编排、检索、工具权限、评测和交接这几层,再决定哪些模型承担哪些负载。只有当每一类任务的完成率、延迟、成本和风险都能被单独观察时,所谓的模型升级才有可能转化为可靠的业务改进。