
它赢的是部署口径,不是总榜
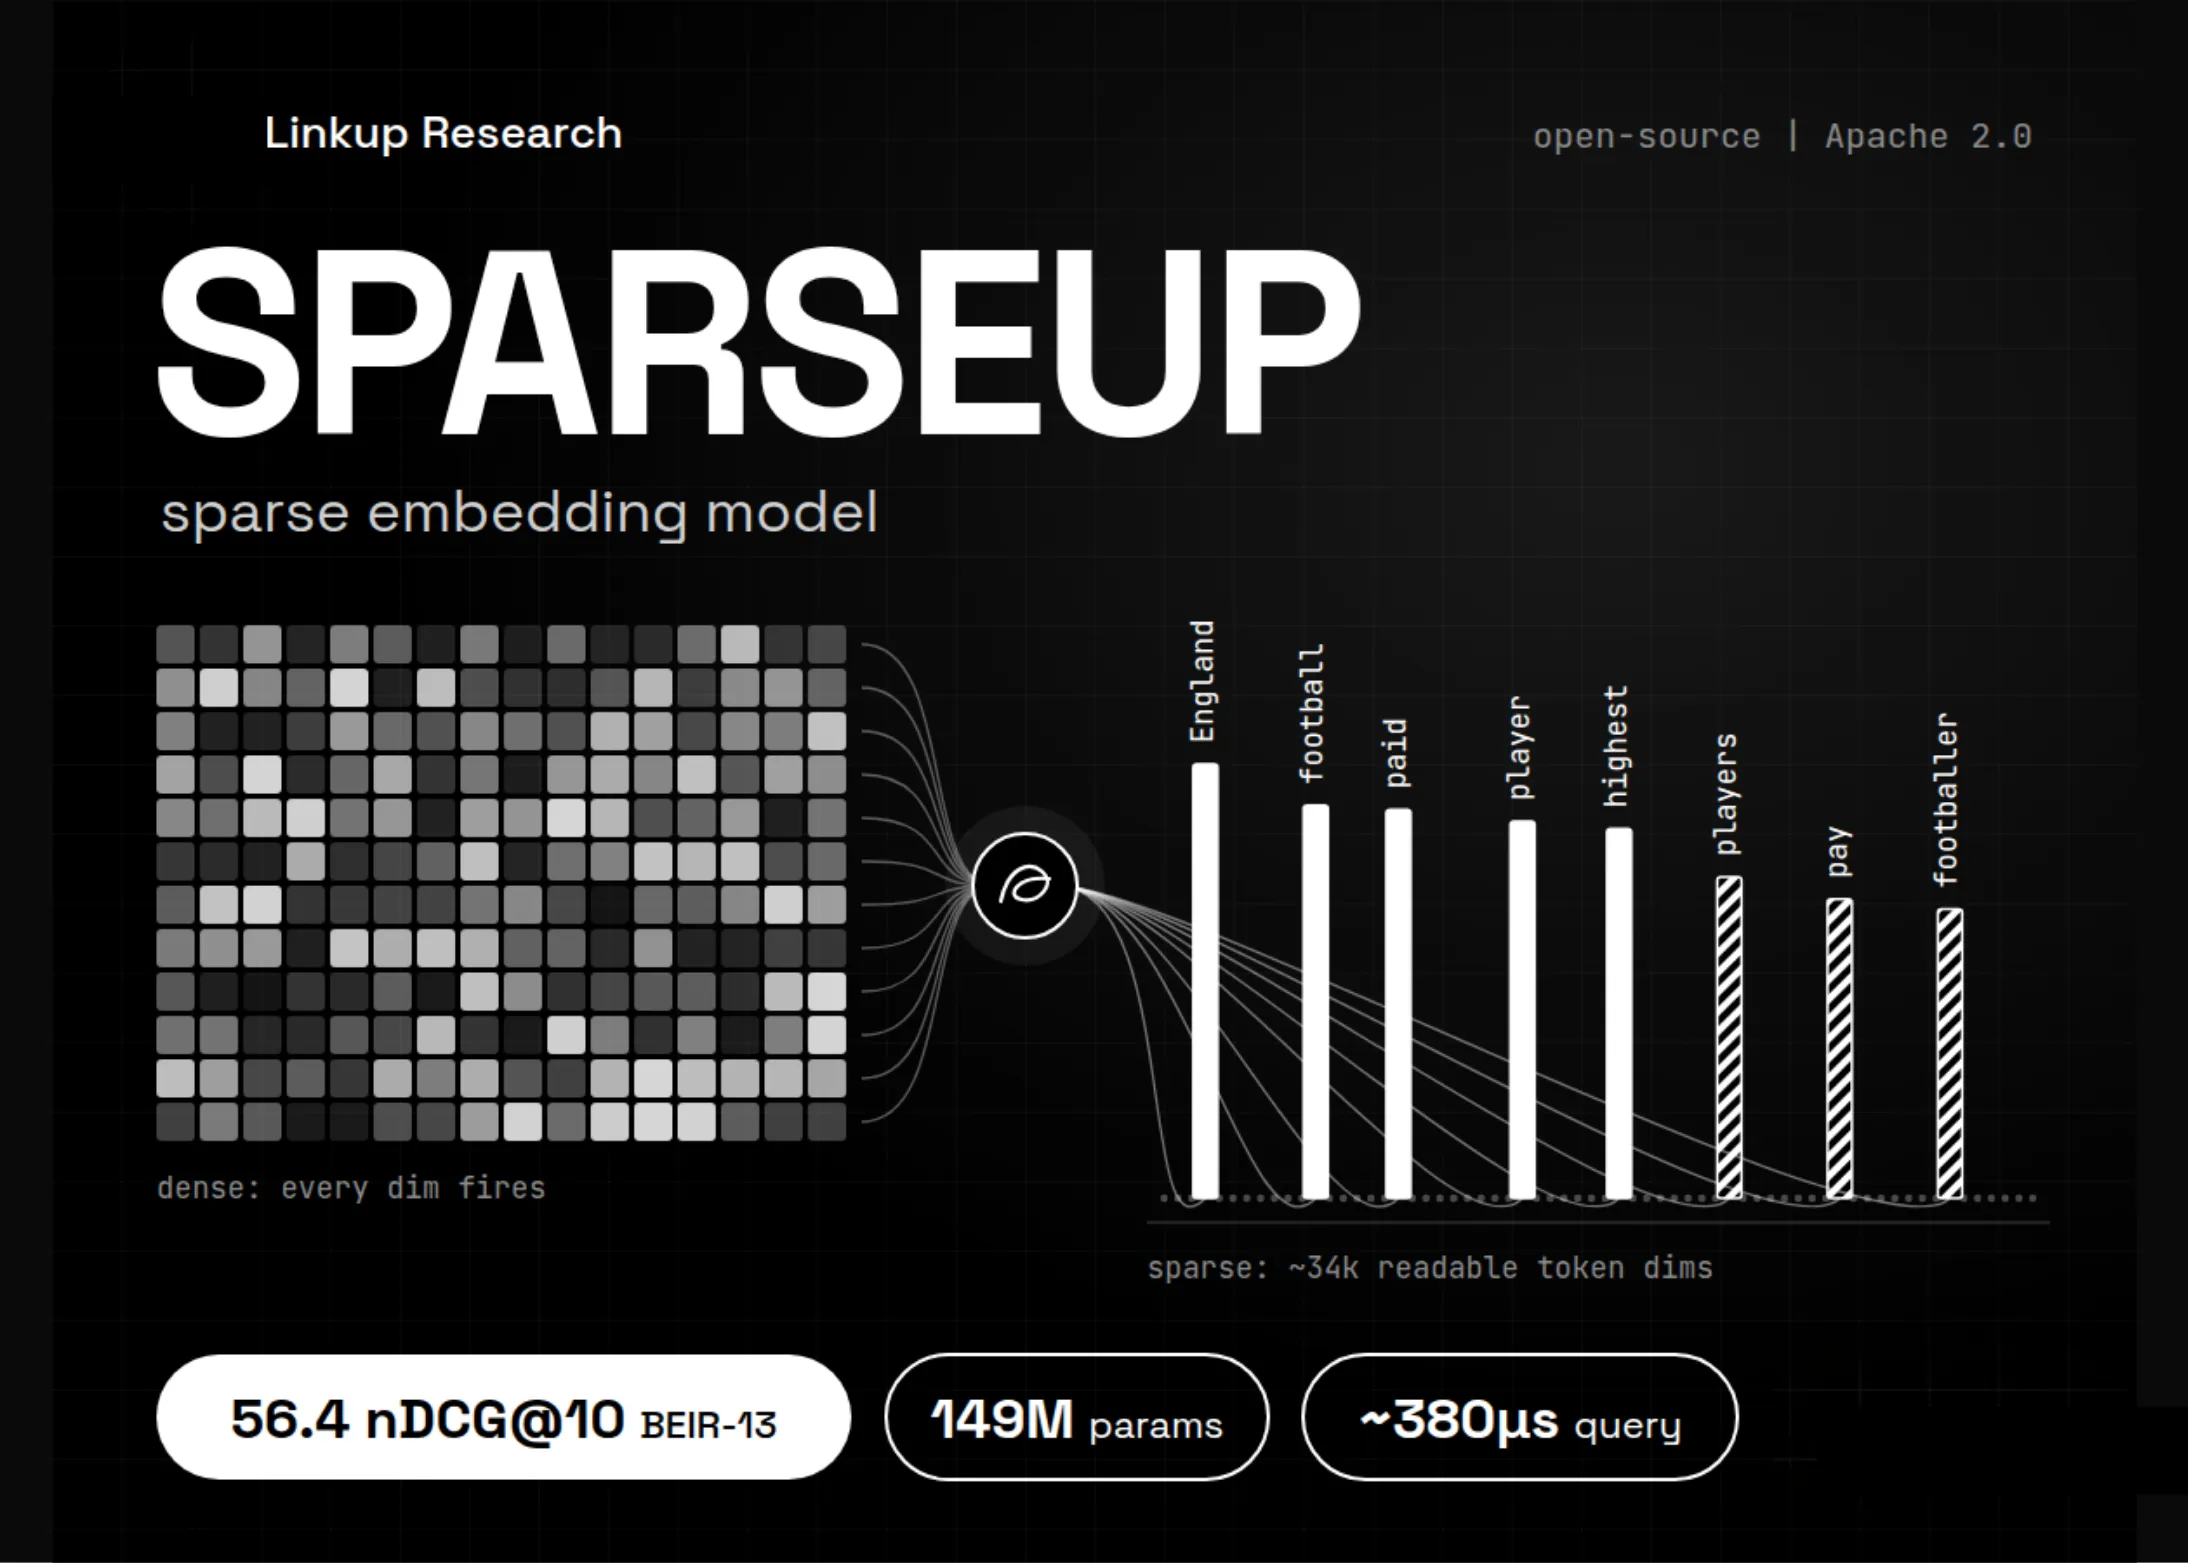
Linkup Research发布了SPARSEUP,一个基于149M参数ModernBERT的开源稀疏嵌入模型,面向的是长期由密集向量主导的检索问题。它不把一段文本压成一个连续向量,而是把文本映射成词表维度上的权重,每个激活维度都对应一个实际词项,因此可以接入倒排索引,也能让工程人员看到匹配究竟落在了哪些词上。
这次发布值得读,不是因为SPARSEUP在所有指标上都超过了更大的模型。Linkup报告的BEIR-13平均nDCG@10为56.4,在其认定的150M参数以下公开词表稀疏编码器中排名最高,但同一配方下的LateOn达到58.9,DenseOn达到57.9,1B参数的LACONIC则为58.7。变化在于,稀疏检索不再只是一个需要牺牲效果来换取可解释性和索引效率的研究分支,它开始成为小规模系统可以认真评估的部署选项。
难点不是生成词袋,而是让词袋别失控
SPARSEUP的设计起点很具体。Linkup从没有MLM头的LateOn-unsupervised检查点开始,重新接回ModernBERT原始的MLM头,再用LightOn的微调数据进行对比学习。每个查询从50个候选中采7个硬负例,同时使用批内负例。训练不依赖交叉编码器蒸馏,并且可以在单张H100上完成,这使它更像一套可复现的检索配方,而不只是一个榜单模型。
初版SPLADE式方案暴露了稀疏模型的核心工程问题:输出虽然名义上稀疏,实际上却被大量停用词和弱激活填满。SPARSEUP用三道限制处理这个问题。它先计算log(1 + ReLU(x - 15)),把低于阈值的logit压掉,再让每个输入词只保留最强的12个词表维度,最后把Byte-level BPE产生的大小写和空格变体折叠到同一词项上。结果是输出维度从约5万降到约3.4万,模型保留了词表可解释性,也避免每个输入词向整个词表无控制地扩散。
稀疏性改变的是系统接口
对系统负责人来说,SPARSEUP最有用的地方不是一个抽象的“可解释性”标签,而是它改变了检索层的接口。查询和文档分别加上[Q]与[D]前缀,最终用点积打分。查询最大长度为128个词元,文档最大长度为512个词元。输出可以进入倒排索引,稀有词仍然保留较强的直接匹配能力,这与把全部信息交给一个不可拆解的密集向量不同。
材料给出的性能证据也支持这种定位。使用Seismic索引时,SPARSEUP单线程查询约380微秒,在报告口径下达到97%以上召回。这个数字说明稀疏模型可以嵌入低延迟召回路径,但不能被误读为所有精确倒排实现都能达到同样速度,因为这里使用的是近似搜索。更稳妥的工程理解是,SPARSEUP提供了一条低成本的词法召回路径,尤其适合与密集模型或晚交互模型组合,而不是单独承担所有语义匹配任务。
同一配方暴露了它的上限
SPARSEUP与DenseOn、LateOn使用同一骨干家族和微调数据,这一设计比单纯比较不同模型的分数更有信息量。它把三种检索范式放在相对接近的条件下比较,也因此清楚显示出稀疏表示的代价:在BEIR-13上,SPARSEUP比DenseOn低1.5分,比LateOn低2.5分。它不是因为参数规模太大才落后,而是在相同训练资源和数据条件下,词表稀疏结构本身限制了语义表达。
数据集分布进一步说明了边界。SPARSEUP在ArguAna、Touché这类依赖关键术语和直接证据的任务上更有优势,但在FiQA、DBPedia等更依赖语义关联的集合上表现较弱。这个结果不意味着稀疏模型只能做传统关键词搜索,而是说明可读的词项权重和连续语义空间解决的是不同问题。把它放在第一阶段做高召回词法候选,再交给密集或晚交互模型重排,比要求它独立完成整个检索链路更符合证据。
部署前要把两个数字拆开看
SPARSEUP的开放性确实降低了试验门槛。权重以Apache 2.0发布,可从Hugging Face获取,并能通过Transformers或Sentence Transformers加载,不过材料明确提到需要trust_remote_code=True。149M参数、单张H100可训练,以及从约5万维压到约3.4万维的输出控制,让自建搜索系统有机会在真实数据上做成本和效果的联合评估,而不必先承担大模型级别的训练投入。
但部署判断不能只看56.4和380微秒。前者是在特定BEIR-13口径下的平均分,且“150M以下最强”是公开词表稀疏编码器这一限定范围内的判断。后者依赖Seismic近似搜索,97%以上召回也属于该设置中的结果。可执行的做法是把SPARSEUP作为一个可替换的召回模块,在自己的倒排库、查询分布和长尾词场景上分别测精确召回、近似召回、索引体积和重排收益。若系统最需要的是稀有实体和术语的稳定召回,它值得进入候选架构。若主要问题是跨表述的语义匹配,仍应保留密集或晚交互模型作为核心。