
先看证据
把机制串起来
工业机器人任务通常分成感知、运动规划和工位逻辑:模型可以负责“看见并认出零件”,而路径与设备协同仍可由传统程序控制。示教微调,是人通过遥操作或示范提供任务例子,让预训练模型适应具体工件和现场;它不等于机器人从少量示范中学会整个生产流程。短时序任务把目标限制在较短的一段操作,更容易把节拍、成功率和安全要求明确地逐项验证。
以机床上下料为例,Standard Bots 称用户可指定要找的零件,零样本感知系统负责定位和识别,传统程序负责运动以及机器人单元的逻辑;这样能把学习模型的职责收窄,避免让模型独自承担整套生产控制。公司称其视觉骨干在超过十亿张图像上训练,以适应照明、材料和物体背景变化;最大模型约为低十亿参数量级,但公开资料没有披露完整架构或任务级评测。模型在云端训练、在本地推理,符合工厂需要现场执行的部署方式;不过材料没有给出延迟、断网表现或实际可靠性数据。公司表示现场介入几十个例子即可修复
['适合零件变化多、视觉识别难但动作流程可编程的工位', '先把模型职责限定在感知,再独立验证运动与安全逻辑', '把现场纠错作为数据采集机会;别默认反馈会自动回流', '不适合直接将其当作整线自主控制或可靠性已获证明']
把问题从“像不像人”改成“能不能稳定干活”
Standard Bots 面向的是机器看护、焊接和装配等工业工位。公司联合创始人兼 CEO Evan Beard 与 AI 负责人 Leif Jentoft 在访谈中介绍的,不是一台试图包办所有工作的通用人形机器人,而是一套把视觉模型、机器人手臂和工位控制组合起来的系统。它要解决的具体问题,是让机器人能在生产现场识别零件并完成相对明确的任务。
这条路线值得技术负责人读,不是因为它宣称模型拥有广泛智能,而是因为工业部署把问题压到了执行层:识别错了怎么办,动作是否足够稳定,停机或返工的成本由谁承担。对工厂来说,模型能力只有进入工位流程,才有生产价值。Standard Bots 的案例因此适合用来拆解“AI 机器人”这个标签背后的系统边界,而不宜直接当作自主机器人已经普遍成熟的证明。
让模型看零件,让程序负责动作
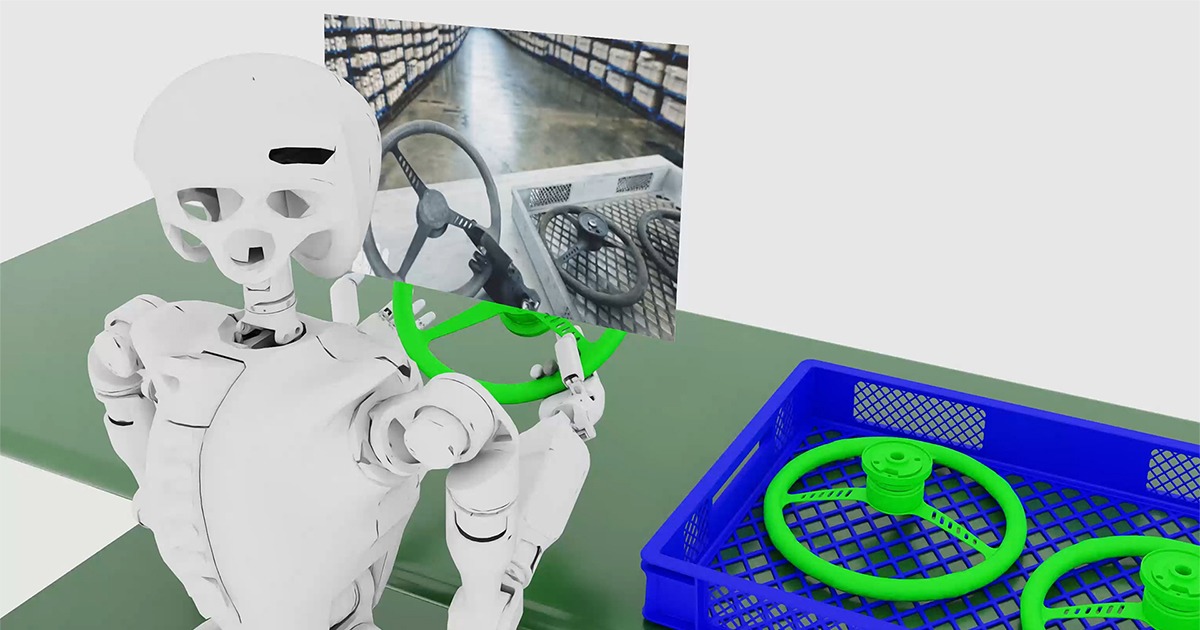
访谈给出的机器看护例子,呈现了一种清晰的职责划分:用户告诉系统要找哪种零件,视觉模型负责定位和识别,传统程序负责机器人运动和单元逻辑。Standard Bots 称其系统能够零样本识别目标零件;Jentoft 还说,相关骨干模型训练使用了超过十亿张图像,以适应不同照明、材料和背景。这些是公司管理者在访谈中的说法,不是材料中附有独立评测的结果。
这种拆分的工程意义在于,不必把整条生产流程都押在一个生成式策略上。材料还称,Standard Bots 聚焦较短时程的任务,以满足节拍和可靠性要求;对于不需要学习行为的流程部分,继续使用常规编程。换句话说,模型解决变化较多的感知问题,程序保留可明确编码的动作与工位逻辑。边界划得越清楚,团队越容易定位错误究竟出在识别、运动还是流程配置。
数据质量的主张,还缺部署后的证据
Jentoft 将数据质量置于原始数据规模之前,并称现场介入有时只需几十个例子就能修正边缘情况。访谈还称,Standard Bots 的最大模型处于十亿级参数的较低区间。这一说法符合工业任务常见的现实约束:要解决的可能是某种零件、某类光照或一个特定工位,而不是让模型处理所有场景。但“数据更有针对性”本身仍是策略主张,不能替代成功率、失败类型和适用范围等部署结果。
公开产品材料能确认的内容更有限:Standard Bots 介绍 Flux VLA 面向生产中的常见精密任务,并允许客户通过手把手遥操作示范进行微调;材料也提到系统从研发及客户网络获得改进。现有资料没有披露训练示范的数量或时长、部署后纠正如何写回模型,也没有给出相应的纠正前后成功率。因此,“现场反馈会持续改善系统”可以作为产品方向来理解,却不能在缺少机制与数据时当作已验证的学习闭环。
本地推理把模型拉回整套硬件
Beard 表示,模型在云端训练、在本地推理。对工厂场景而言,这意味着执行发生在机器人所在的现场,而不是依赖每次动作都往返云端。Standard Bots 也称自己控制机器人手臂、末端执行器、控制系统和 AI,并据此把模型与控制策略共同优化。这里的重点不是“全栈”这个标签,而是模型性能与具体硬件、控制链路之间存在依赖。
这种整合可能缩短系统迭代路径,也让部署更受设备约束。模型能否迁移到另一款机械臂、不同的末端执行器或控制器,不应从一套设备上的表现直接推断。访谈中 Jentoft 认为当前模型并非真正硬件无关;材料同时提到 Skild 正在追求跨硬件泛化。两者代表不同取舍:针对一套设备共同优化,可能换来更紧密的性能配合,但也需要进一步验证换硬件时要付出的适配成本。
别把 Rho 的纠正实验记到 Standard Bots 名下
这里有一个容易混淆的证据边界。Microsoft Research 的 Rho 公开了更具体的预训练、机器人适配和部署后纠正机制;它约有 50 亿参数,使用超过 3,200 小时的机器人数据预训练,并形成三种机器人适配版本。其单任务微调约需 100 至 300 条实体机器人示范。这些数字属于 Microsoft 的研究,不是 Standard Bots 的模型数据。
Rho 的实验还报告,在 FR3 Duo 的试管装配任务中,最难配置的成功率在 15 个纠正回合后从 30% 提高到 70%。这说明部署中的人工纠正可以成为一种可量化的改进路径,但结果只适用于该模型、任务和实验设置,不能外推为工厂生产成功率,更不能补足 Standard Bots 尚未公开的机制。评估类似系统时,应分别索取任务边界、异常接管方式、纠正数据如何使用,以及换工位或换硬件后的表现;没有这些信息,“能从现场学习”仍不足以构成可靠性的证据。