

先看证据
把机制串起来
大模型在长文本处理中,经常需要像程序员调试代码或读者追踪小说剧情一样,维护实体和变量的动态变化。这种在长文档中持续更新状态的能力被称为状态跟踪,它直接决定了模型处理复杂逻辑的上限。
StateBench 将底层更新序列映射为四种难度:R-trivial(不可变赋值)、Aperiodic(值覆盖更新)、Soluble(自引用累加)和 General Finite(跨变量引用交换)。论文基于有限幺半群与 Krohn-Rhodes 分解理论,确保各难度层级的样本等价且可控。通过将同一底层逻辑渲染为代码、电子表格等六种表面格式,有效排除了模型对特定文体的过拟合。
['评估长文本模型时,切勿只看静态事实检索,应引入多步骤状态更新测试其逻辑连贯性。', '面对长代码阅读或复杂剧情追踪场景,纯 Transformer 架构容易在长依赖链中丢失状态。']
长文本检索的盲区:静态事实与动态状态的本质区别
艾伦人工智能研究所(Ai2)于 2026 年 11 月发布了长上下文状态跟踪基准 StateBench,直接面向大模型在海量文本中维护实体与变量状态的能力。过去的长文本评测多关注模型能否从几十万 Token 中捞出某个静态事实,而 StateBench 关注的是当实体随文档进展不断演化时,模型是否还能准确追踪。无论是代码阅读中变量的反复赋值,还是推理小说中角色不断互换道具,核心都在于沿着一串更新持续维护当前状态。
这种能力与单纯的“大海捞针”有着本质区别。部分任务只需找到最近一次更新即可,但更复杂的场景要求模型必须处理长依赖链,其中任何一个环节的遗漏都会导致最终答案完全错误。随着各大厂商不断提升上下文长度,开发者急需一种能够系统性衡量模型状态跟踪极限的工具,而不是停留在泛泛的吞吐量宣传上。
四个难度层级:从不可变赋值到有限状态引用
StateBench 将状态跟踪问题严格划分为四个难度级别,对应计算机科学中的四类变量赋值操作。最简单的 r-trivial 类似不可变赋值,变量值从头到尾保持不变,模型只需找回初始设置即可。第二级 aperiodic 允许按值覆盖赋值,模型需要找到最新值并忽略历史干扰。第三级 soluble 引入自引用更新,每个更新都建立在当前值之上,类似于游戏积分需要累加。最难的 general finite 则引入变量间引用和交叉替换,要求模型追踪跨变量的复杂依赖关系。
为了将这些直观的编程概念数学化,论文借助了代数中的 Krohn–Rhodes 分解理论,将状态跟踪问题视为有限幺半群上的字问题。为了控制变量,研究人员先生成一般有限状态更新序列,再将其转换为四种难度版本,并把同一底层任务呈现为六种不同的文本格式,包括整数代码、电子表格和方块涂色。这种设计有效排除了模型对特定表面文法的依赖,真正测试其底层的逻辑追踪机制。
前沿闭源模型的崩溃边界:长序列下的准确率滑坡
在对前沿闭源模型和主流预训练模型的评测中,StateBench 揭示了普遍存在的性能边界。根据 Ai2 的测试数据,当输入长度达到 10K 到 64K tokens 之间时,前沿模型在 soluble 和 general finite 任务上的表现会急剧退化至接近随机水平。博文指出,在最长的 general finite 测试中,部分前沿模型的准确率甚至跌至 13% 或更低。
这表明当前的闭源巨头在面对长距离的复杂状态依赖时,依然缺乏稳健的内部计算机制。随着上下文变长,注意力机制和有限的隐状态在处理多步交错更新时逐渐失效。模型往往在处理前段赋值时尚可保持正确,但在经历数十次甚至上百次状态更迭后,累积的误差彻底冲垮了最终的推理结果。
架构分水岭:循环与混合模型展现出的泛化优势
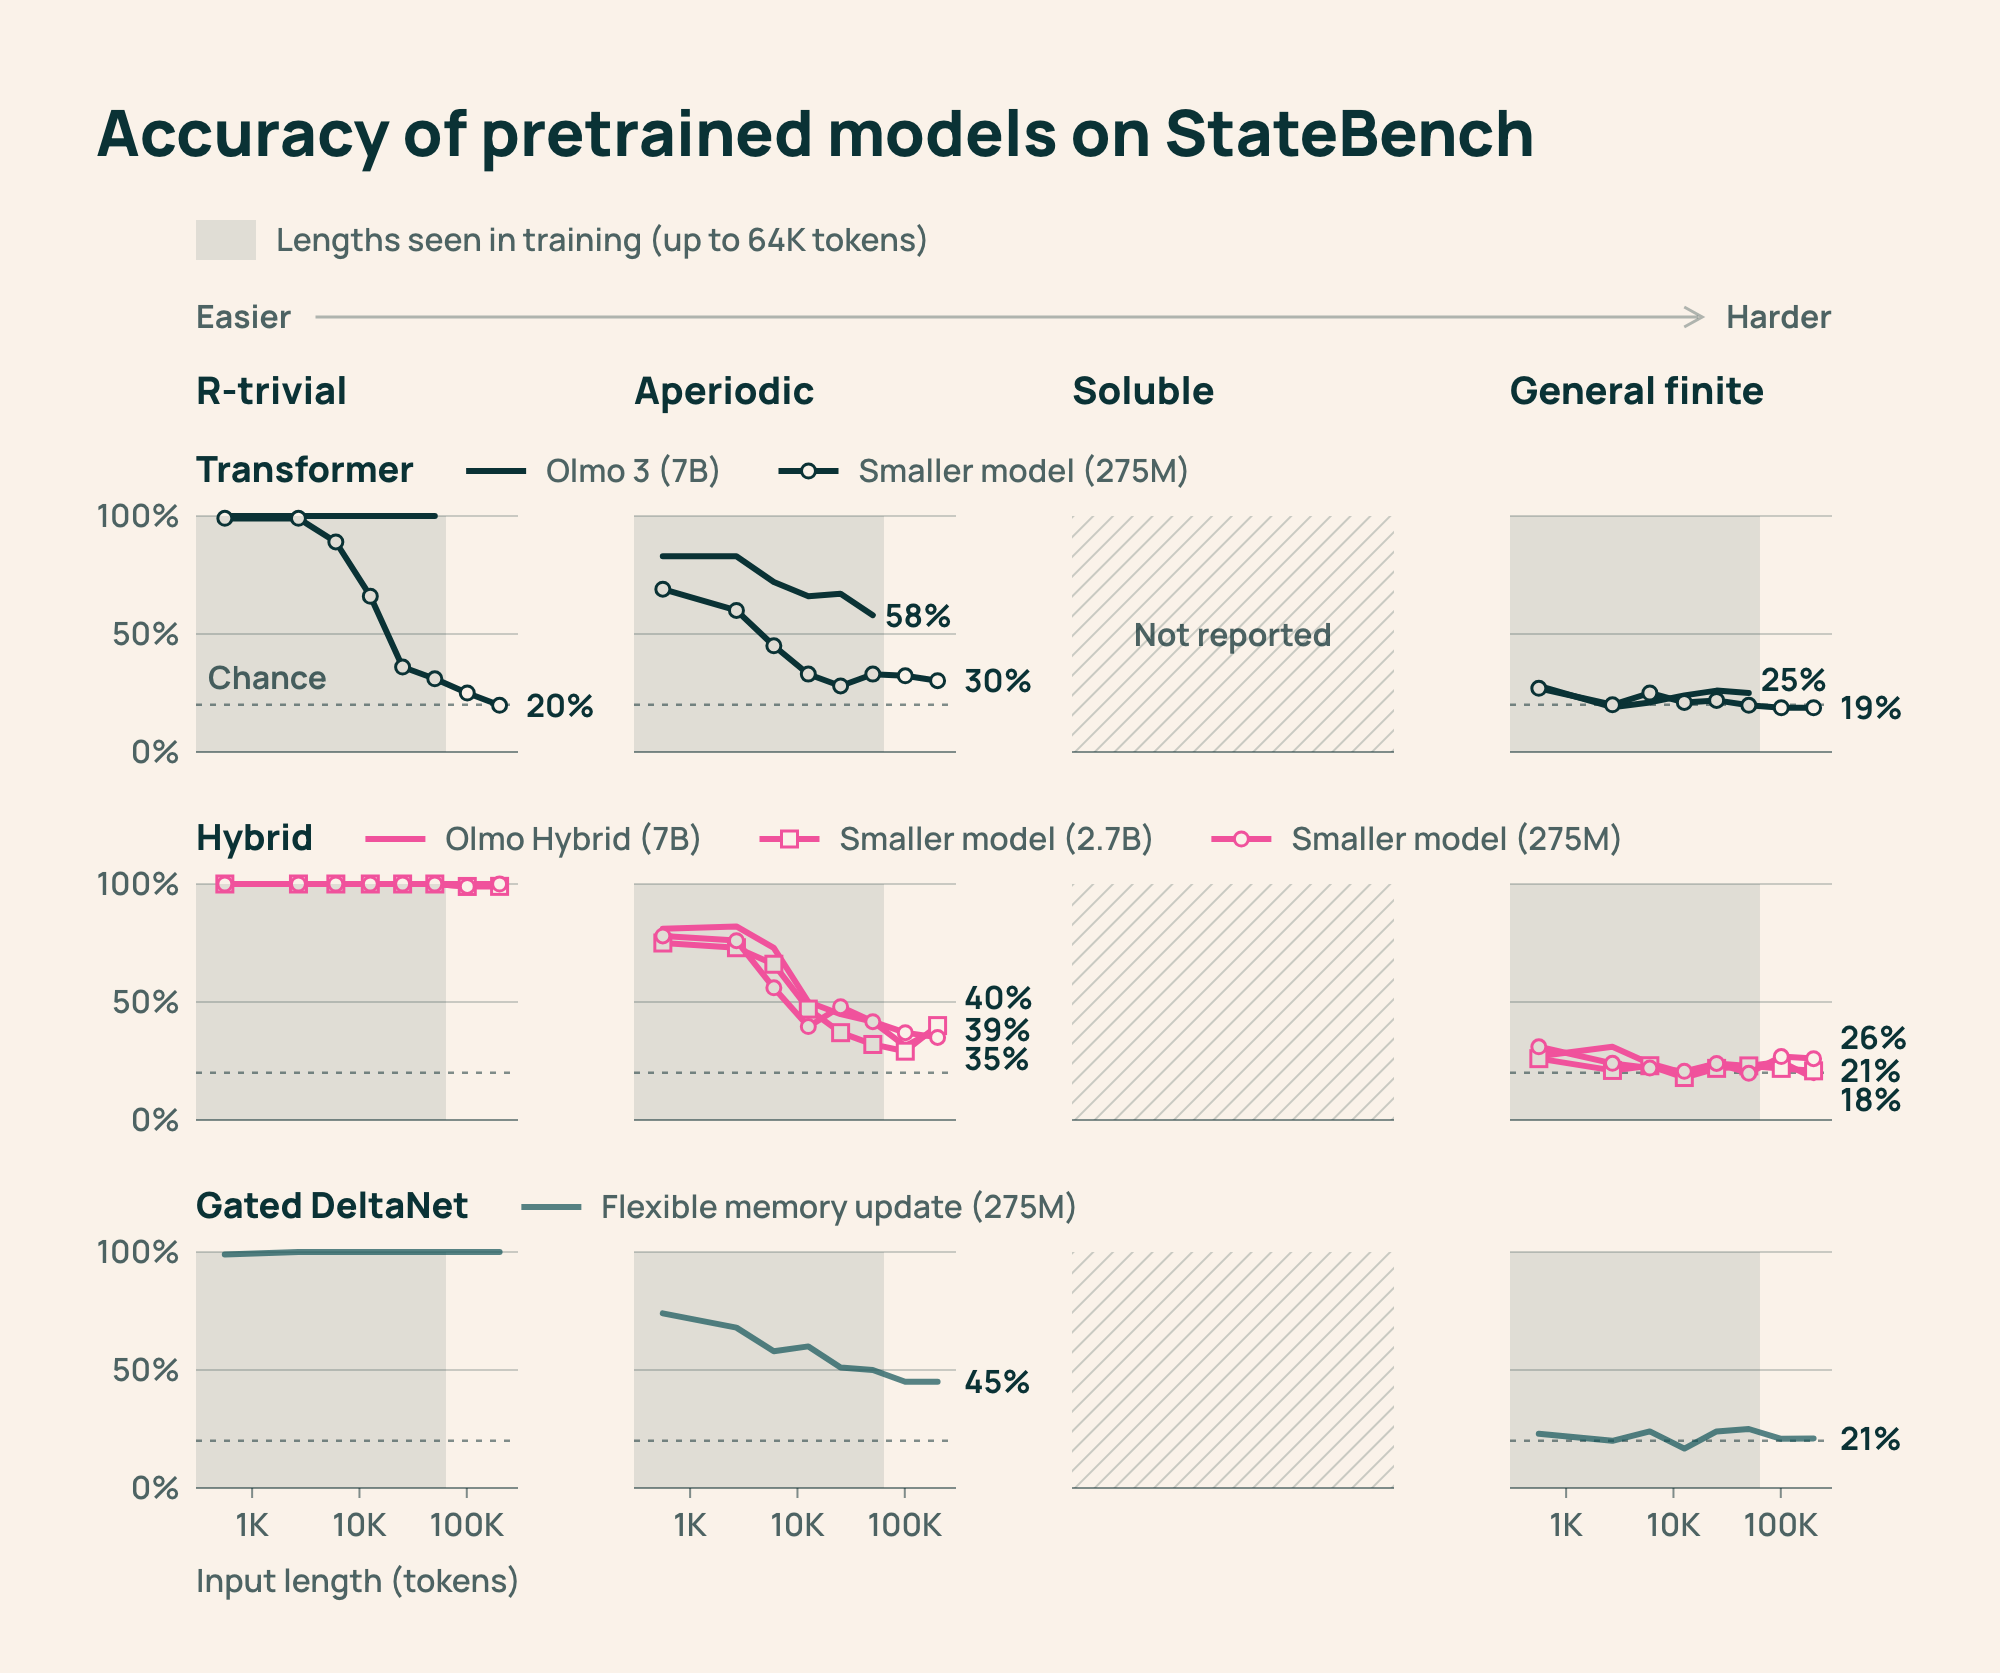
除了评估现有模型,研究还直接在 StateBench 上对不同架构进行了训练对比,涉及 Transformer、Gated DeltaNet(GDN)以及混合架构。实验显示,在直接使用这些任务进行训练时,循环和混合模型表现出了远超 Transformer 的长度泛化能力。参数量为 275M 的 GDN 变体在面对最难的 general finite 任务时,能够泛化到训练序列长度的 10 倍左右才开始退化。
相比之下,传统的 Transformer 架构在最难的级别上未能学会相应的训练分布任务。带有正负特征值的 GDN 变体通过携带前向运行记忆,能够更有效地处理跨变量引用和状态重排。这说明架构选择直接决定了模型能否通过递归或状态传递来维持长距离依赖,而不是盲目依赖堆叠注意力层。
工程落地启示:如何审视长上下文应用的实际代价
对于将大模型应用于代码库分析、复杂工作流状态机维护或长文本推理的技术团队来说,StateBench 带来了明确的警示。开发者不能再以宣传资料中的最大 Token 容量作为系统可靠性的依据。当实际业务涉及频繁的变量覆盖、状态累加或多对象引用时,模型在几万 Token 后产生幻觉或逻辑崩溃的概率会急剧上升。
在选择基础设施时,架构的内在特性开始占据主导地位。如果业务场景包含大量的状态演化与强依赖链,单纯依赖 Transformer 架构可能面临天然的泛化天花板,而引入具有显式记忆维持能力的混合或循环架构将成为破局方向。团队在构建生产环境时,必须对长上下文任务进行分级评测,明确界定模型能够完美处理的状态更新步数上限。