


先看证据
从叠衣服演示到一间培养皿
Ai2 在 Hugging Face 博客上发布了 ToyBlocks,并把它归入一个更大的框架 FoundationWorlds。这个框架的目标不是直接造出更强的机器人,而是为机器人学习提供一种可控的模拟世界:每个世界针对一类具体环境,配套自动生成任务与演示的工具,以及观察机器人行为随时间变化的指标。首个世界 ToyBlocks 围绕一张桌面上的一条机械臂和若干积木展开。
这个发布之所以值得技术负责人读,是因为它回应的不是能力问题,而是方法论问题。博客开头点明了一个现状:机器人正在学叠衣服、分拣零件、处理陌生物体,但这些演示往往相当狭窄,既不能说明机器人到底学到了什么,也不能解释它为什么失败。ToyBlocks 的定位就是给这类问题提供一个可重复、可变量控制的实验台。
四个要求与一个刻意的窄口径
ToyBlocks 被设计成满足四个要求:真实的物理与外观、大规模自动生成任务和演示、把推理与灵巧操作结合起来的挑战,以及对一个领域内可能任务的广泛覆盖。博客明确承认,开放式的领域需要建模大量物体和交互,要同时满足这四条并不可行;ToyBlocks 的窄口径反而让它有可能全部满足。
这是一个重要的取舍信号。它没有宣称自己是一个通用机器人基准,而是选择在一个小世界里做到‘模拟臂和积木的行为与物理对应物非常相似’。换句话说,覆盖面被主动让渡,换来的是对物理保真度和任务生成可控性的信心。对读者来说,这意味着 ToyBlocks 的结论更适合回答机制性问题,而不是给出跨场景的能力排名。
演示不再靠遥操作:训练数据变成可调变量
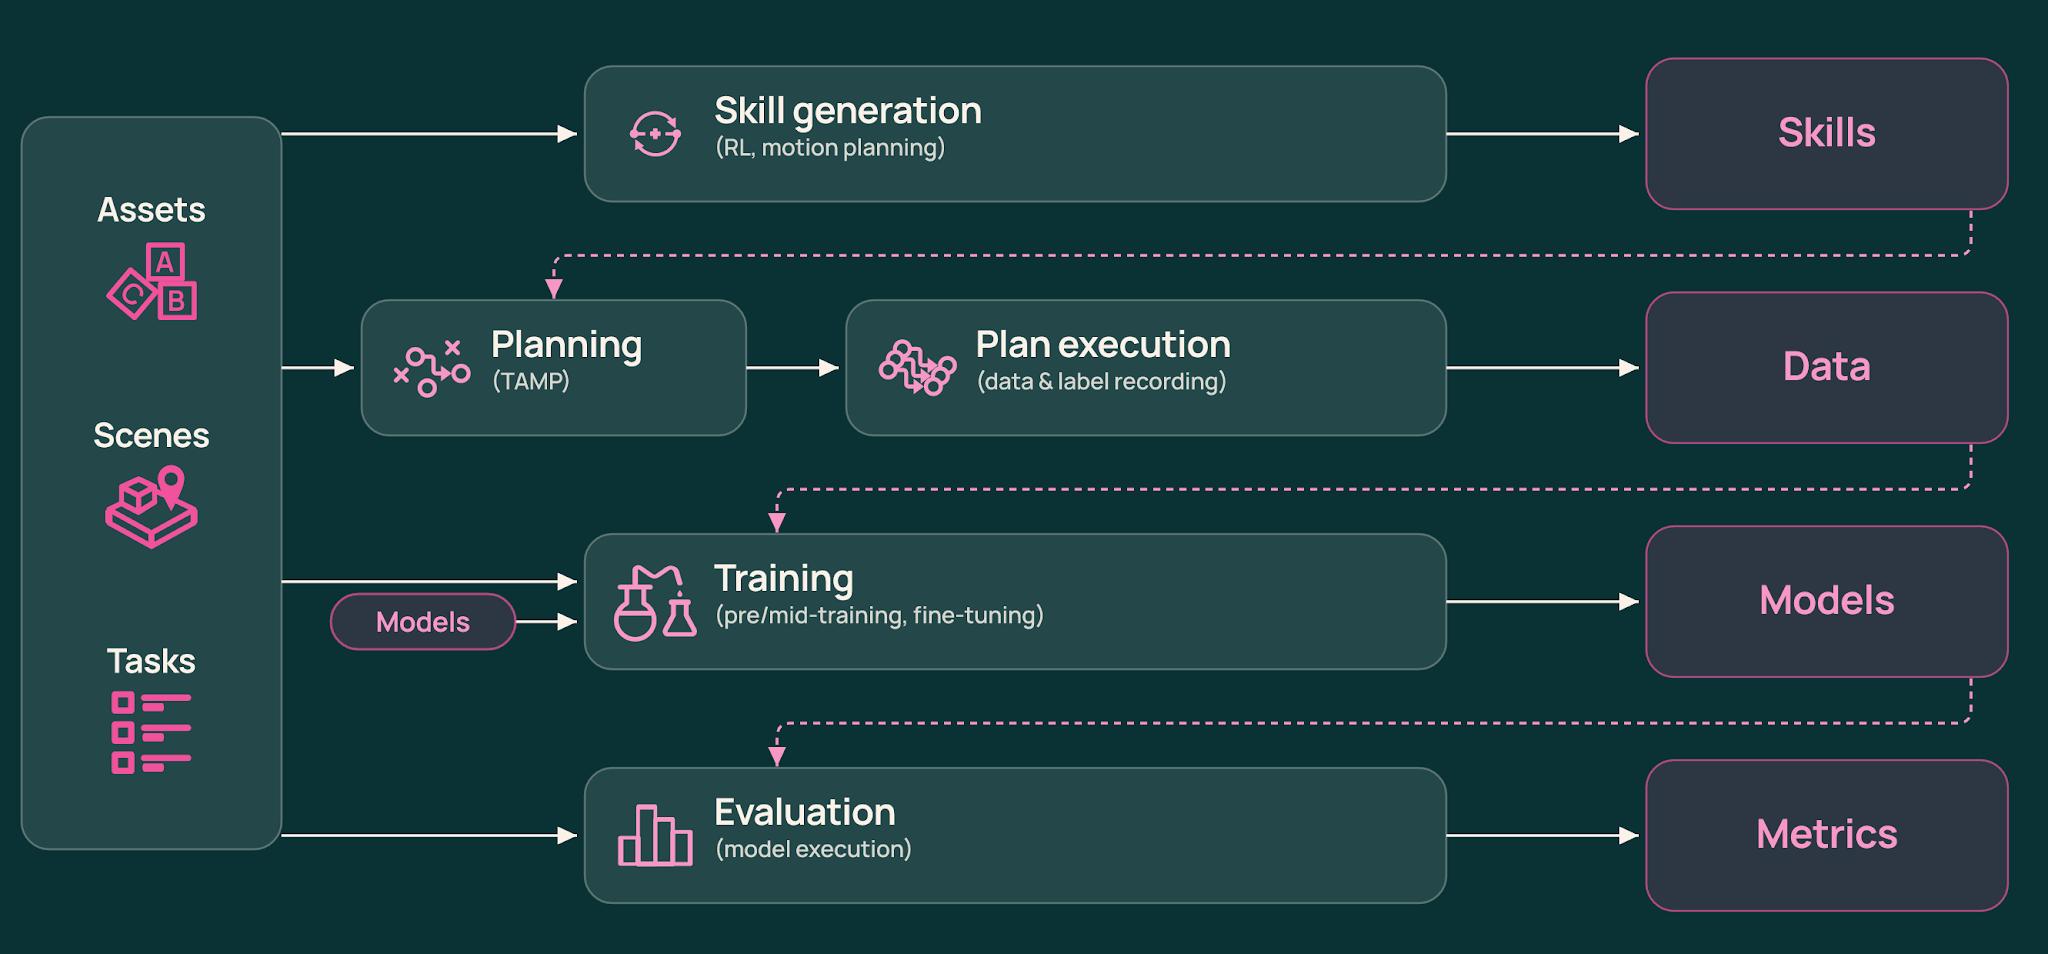
ToyBlocks 自动生成演示,也就是机器人在仿真中完成任务的记录,不需要耗时的人工遥操作。这一点改变了实验的形态:团队可以生成更多推、翻或堆叠的演示,然后在未参与训练的任务上评估表现。训练经验的分布因此从固定数据集变成一个可以拨动的参数。
机制上,框架用强化学习和运动规划来生成短时程任务的技能,技能训练在 Isaac Lab 中进行。通过试错,这些策略学会推、翻、堆这类非抓取技能。同时,高层推理模型决定做什么,低层动作模型控制机械臂怎么动。这种分层让研究者可以分别改变推理侧或控制侧,再去观察失败发生在哪一层。
积木面上的字母:推理与灵巧的交汇点
ToyBlocks 并不只是抓取和堆叠。积木面上有图片和字母,这让搜索、排序和排列类任务成为可能。机器人可能需要先转动一块积木,看到隐藏的面,才能决定它该放在哪里。这个设计把高层语义判断和低层物理操作绑在同一个任务里,而不是让它们各自独立评测。
另一个变量是域随机化:在不同场景间改变积木尺寸、桌面高度和其他物理属性,用来测试模型在几何变化下的泛化能力。这比固定场景的评测更接近真实世界的分布偏移,但仍然在可控范围内。对做具身智能的团队来说,这种设置提供了一种拆分方式:失败究竟来自看不懂任务,还是来自在变化几何下控制不稳。
对实际工作的意味:先问归因,再谈能力
如果团队正在做机器人学习,ToyBlocks 最直接的用法不是拿它刷一个高分,而是把它当作假设检验的工具。博客明确说,这个框架可以用来设计实验和验证假设,也包括对已训练模型做额外训练以适配新任务。一个可行的流程是:固定模型结构,只改变演示的分布,观察性能曲线如何随数据量变化;或者固定数据,只改高层推理与低层控制的组合方式。
这也意味着评测指标的角色变了。指标不再只是最终成功率,而是用来观察机器人行为随时间的变化,从而定位失败模式。对技术负责人来说,这要求把评测设计提前到项目初期,而不是在模型训练完之后补一个跑分。ToyBlocks 提供的是一套实验基础设施,价值取决于团队是否愿意把问题拆成可操控的变量。
边界:小世界里的结论不能直接搬出去
ToyBlocks 的边界和它的优势是同一个东西:窄。因为只覆盖桌面上的一条机械臂和积木,它能把物理保真、自动任务生成和推理加灵巧的挑战同时做到,但这也意味着在这个世界里得到的结论,不能直接外推到叠衣服、分拣零件或杂乱的真实场景。博客把它称为第一个 FoundationWorld,并说目标是扩展到越来越复杂的环境,这本身说明当前版本仍是一个起点。
因此更稳妥的判断是:把 ToyBlocks 看作研究因果机制和失败归因的受控环境,而不是通用能力认证。它继承自 Ai2 此前的开放机器人学习工作,包括 MolmoAct 2、MolmoBot 和 MolmoSpaces,定位是让研究者在刻意受限的领域里把问题问清楚。真正需要观察的,是这套方法在扩展到更复杂世界时,四个要求之间的取舍会不会重新变得不可调和。